

Python per l’analisi dei dati: machine learning con Scikit-Learn
Scritto da Yasin TANIŞ
Introduzione
Il machine learning è la branca della scienza che permette ai computer di imparare dai dati e fare previsioni, e oggi si usa in molti settori. In questo articolo vediamo Scikit-Learn, una delle librerie Python più usate per creare applicazioni di machine learning.
Che cos’è Scikit-Learn
Scikit-Learn è una libreria di machine learning che offre strumenti semplici ed efficienti per Python. Include sia algoritmi di apprendimento supervisionato sia algoritmi di apprendimento non supervisionato.
Installazione
Prima di iniziare bisogna installare la libreria. Se non è ancora presente sul tuo sistema, installala con questo comando:
pip install scikit-learnNota: gli esempi qui riportati sono volutamente semplici per illustrare i concetti; non sono sempre la metrica o il metodo migliore per ogni scenario.
Apprendimento supervisionato
L’apprendimento supervisionato lavora con dati etichettati: gli esiti (etichette) degli esempi sono noti, così il modello può imparare a prevederli.
Regressione logistica
La regressione logistica è un algoritmo molto usato per i problemi di classificazione.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Questo codice carica il dataset Iris, lo divide in feature e target, addestra il modello e ne stampa l’accuratezza.
Alberi decisionali
Gli alberi decisionali sono un algoritmo potente sia per la classificazione sia per la regressione.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Apprendimento non supervisionato
L’apprendimento non supervisionato non usa dati etichettati; il modello cerca di apprendere da sé la struttura dei dati.
Clustering K-Means
K-Means è un comune algoritmo di clustering che divide i dati in k cluster.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()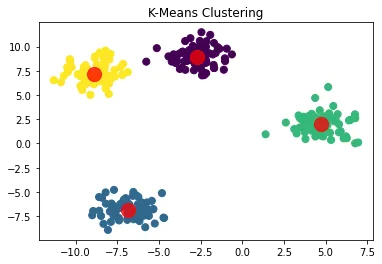
Analisi delle componenti principali (PCA)
La PCA è una tecnica per ridurre dati ad alta dimensionalità a un numero inferiore di dimensioni.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()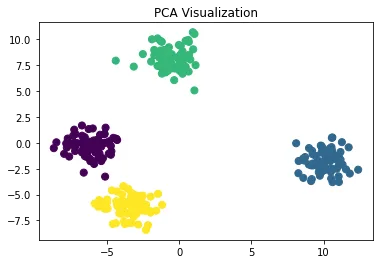
Tuning degli iperparametri
Il tuning degli iperparametri è un passaggio importante per ottenere il meglio da un modello. La classe GridSearchCV di Scikit-Learn lo rende semplice.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Le etichette dell’output sono in turco perché il codice originale le stampa così: «parametri migliori» e «punteggio migliore».)
Validazione incrociata
La validazione incrociata è una tecnica importante per misurare quanto bene un modello generalizzi su dati nuovi.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Nota di correzione: i punteggi bassi qui dipendono dal passaggio precedente, non dal modello. Il codice di ricampionamento mescola a caso le righe di X ma non mescola allo stesso modo le etichette di y, quindi le etichette non corrispondono più alle righe e il modello scende al livello di una scelta casuale (circa 0,33 con tre classi). Se salti questo passaggio o selezioni X e y con gli stessi indici, i punteggi risalgono. Le metriche e il risultato della pipeline più sotto sono bassi per lo stesso motivo, perché usano gli stessi dati.
Selezione e ingegneria delle feature
La selezione e l’ingegneria delle feature hanno un ruolo chiave nelle prestazioni del modello. Scikit-Learn offre strumenti che semplificano questi passaggi.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Interpretabilità del modello
Soprattutto con modelli come gli alberi decisionali, è importante capire come il modello prende le sue decisioni.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()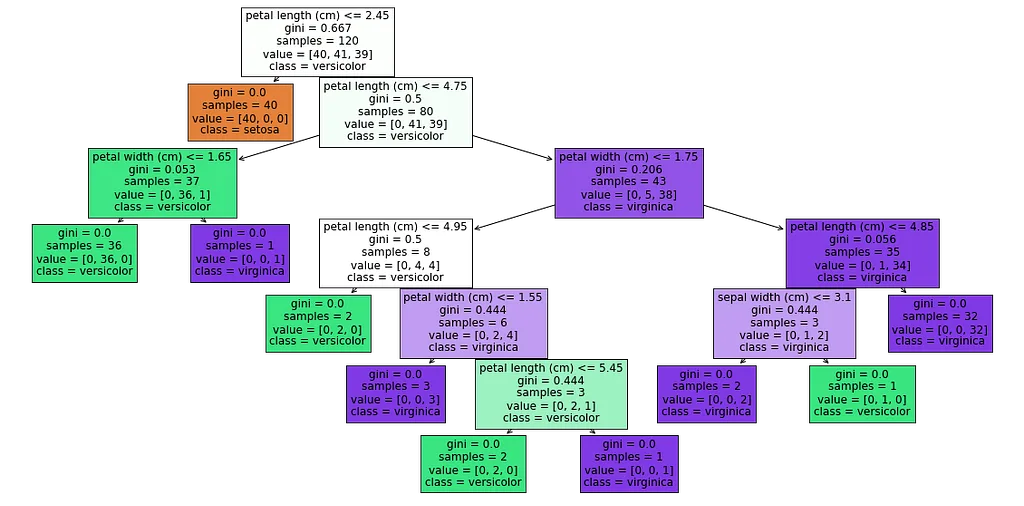
Il diagramma mostra l’albero decisionale di un classificatore addestrato sul dataset Iris. Con poche regole l’albero separa le classi setosa, versicolor e virginica:
- Nodo radice: condizione petal length ≤ 2.45 cm; Gini 0.667; 120 esempi, distribuzione [40, 41, 39]. Qui le classi sono più mescolate.
- Nodo figlio sinistro: Gini 0.0; tutti i 40 esempi sono setosa. Una sola regola isola completamente setosa.
- Nodo figlio destro (petal length > 2.45 cm): Gini 0.5; 80 esempi, distribuzione [0, 41, 39]. Versicolor e virginica sono ancora mescolate.
- Separazione più fine: condizione petal length ≤ 4.75 cm; Gini 0.206; 43 esempi, distribuzione [0, 5, 38], soprattutto virginica.
- Nodi inferiori: condizione petal width ≤ 1.75 cm; Gini 0.0; tutti i 35 esempi sono virginica.
Ogni nodo mostra il coefficiente di Gini, il numero di esempi e la distribuzione delle classi, così puoi seguire esattamente quale feature il modello usa in quale punto e come prende le sue decisioni.
Metodi ensemble
I metodi ensemble combinano più modelli per ottenere previsioni più solide. Random Forest è tra i più popolari.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Metriche di valutazione
Oltre all’accuratezza, contano anche altre metriche di valutazione.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)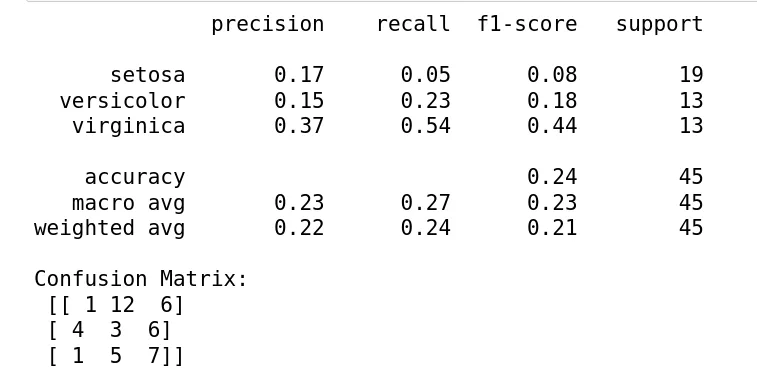
Questi risultati mostrano le prestazioni di un modello addestrato sui dati mescolati in precedenza:
- Precisione, la quota di previsioni positive corrette: setosa 17%, versicolor 15%, virginica 37%.
- Richiamo (recall), la quota di veri positivi trovati: setosa 5%, versicolor 23%, virginica 54%.
- Punteggio F1, la media armonica di precisione e richiamo: setosa 0.08, versicolor 0.18, virginica 0.44.
- Accuratezza complessiva: 24%.
- Media macro: precisione 23%, richiamo 27%, F1 23%. Media ponderata: precisione 22%, richiamo 24%, F1 21%.
Nella matrice di confusione 1 esempio di setosa è previsto correttamente, 12 come versicolor e 6 come virginica; per versicolor 3 corretti, 4 come setosa e 6 come virginica; per virginica 7 corretti, 1 come setosa e 5 come versicolor.
Interpretazione e suggerimenti
Le prestazioni complessive sono basse; virginica va meglio, ma non abbastanza. Come spiega la nota di correzione precedente, la causa principale sono le etichette mescolate. Oltre a questo, in genere i seguenti accorgimenti migliorano le prestazioni:
- Provare modelli più potenti come Random Forest o SVM e regolarne gli iperparametri
- Aggiungere nuove feature o trasformare quelle esistenti
- Bilanciare le classi con metodi come SMOTE se sono sbilanciate
- Usare la validazione incrociata per individuare overfitting o underfitting
Un’applicazione reale: la segmentazione dei clienti
Come applicazione reale, consideriamo la segmentazione dei clienti di un’azienda di e-commerce.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Le pipeline di Scikit-Learn
Una pipeline concatena le fasi di pre-elaborazione e di addestramento del modello, rendendo il codice più pulito ed efficiente.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Caso di studio: classificazione con il dataset Iris
In questo caso di studio applichiamo diversi algoritmi di machine learning al dataset Iris e confrontiamo i risultati.
Preparare i dati
Per prima cosa carichiamo il dataset e lo dividiamo in set di addestramento e di test.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Applicare e confrontare gli algoritmi
Ora applichiamo regressione logistica, albero decisionale e KNN e confrontiamo i risultati.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Conclusione
In questo articolo abbiamo percorso le fasi di un processo di machine learning con Scikit-Learn e visto come applicarle. Abbiamo usato algoritmi supervisionati e non supervisionati sul dataset Iris e, oltre agli algoritmi di base, abbiamo trattato ottimizzazione, valutazione e interpretazione, un’applicazione reale e le pipeline. Con la sua ampia gamma di strumenti, Scikit-Learn rende più semplice per data scientist e professionisti del machine learning risolvere problemi complessi.
Fonti
- Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Documentazione di Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. e Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. e Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. e Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. e Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.