

Python për analizën e të dhënave: mësimi automatik me Scikit-Learn
Shkruar nga Yasin TANIŞ
Hyrje
Mësimi automatik është fusha shkencore që u mundëson kompjuterëve të mësojnë nga të dhënat dhe të bëjnë parashikime, dhe sot përdoret në shumë sektorë. Në këtë artikull shohim Scikit-Learn, një nga bibliotekat Python më të përdorura për ndërtimin e aplikacioneve të mësimit automatik.
Çfarë është Scikit-Learn
Scikit-Learn është një bibliotekë mësimi automatik që ofron mjete të thjeshta dhe efikase për Python. Ajo përmban algoritme si për mësimin e mbikëqyrur, ashtu edhe për atë të pambikëqyrur.
Instalimi
Para se të fillojmë, biblioteka duhet të instalohet. Nëse nuk e keni ende në sistem, instalojeni me këtë komandë:
pip install scikit-learnShënim: shembujt këtu janë qëllimisht të thjeshtë për të ilustruar konceptet; nuk janë gjithmonë metrika ose metoda më e mirë për çdo skenar.
Mësimi i mbikëqyrur
Mësimi i mbikëqyrur punon me të dhëna të etiketuara: rezultatet (etiketat) e shembujve dihen, ndaj modeli mund të mësojë t’i parashikojë.
Regresioni logjistik
Regresioni logjistik është një algoritëm i përdorur gjerësisht për problemet e klasifikimit.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Ky kod ngarkon grupin e të dhënave Iris, e ndan në veçori dhe objektiv, trajnon modelin dhe shfaq saktësinë e tij.
Pemët e vendimit
Pemët e vendimit janë një algoritëm i fuqishëm si për klasifikim, ashtu edhe për regresion.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Mësimi i pambikëqyrur
Mësimi i pambikëqyrur nuk përdor të dhëna të etiketuara; modeli përpiqet vetë të mësojë strukturën e të dhënave.
Grupimi K-Means
K-Means është një algoritëm i zakonshëm grupimi që i ndan të dhënat në k grupe.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()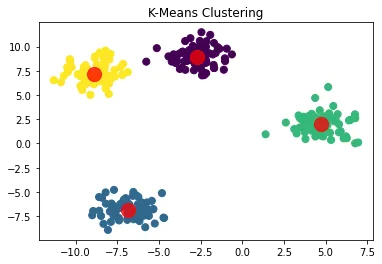
Analiza e komponentëve kryesorë (PCA)
PCA është një teknikë për t’i reduktuar të dhënat shumëdimensionale në më pak dimensione.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()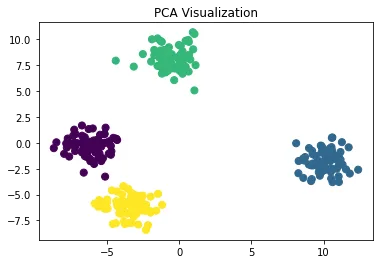
Rregullimi i hiperparametrave
Rregullimi i hiperparametrave është një hap i rëndësishëm për të arritur performancën më të mirë të një modeli. Klasa GridSearchCV e Scikit-Learn e lehtëson këtë.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Etiketat në rezultat janë në turqisht, sepse kodi origjinal i shfaq kështu: „parametrat më të mirë“ dhe „rezultati më i mirë“.)
Validimi i kryqëzuar
Validimi i kryqëzuar është një teknikë e rëndësishme për të matur sa mirë përgjithësohet modeli te të dhëna të reja.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Shënim korrigjimi: rezultatet e ulëta këtu vijnë nga hapi i mëparshëm, jo nga modeli. Kodi i rimostrimit i përzien rastësisht rreshtat e X, por etiketat në y nuk i përzien në të njëjtën mënyrë, ndaj etiketat nuk përputhen më me rreshtat dhe modeli bie në nivelin e rastësisë (rreth 0,33 me tri klasa). Nëse e anashkaloni këtë hap ose i zgjidhni X dhe y me të njëjtët indekse, rezultatet rriten sërish. Metrikat dhe rezultatet e pipeline-it më poshtë janë të ulëta për të njëjtën arsye, sepse përdorin të njëjtat të dhëna.
Përzgjedhja dhe inxhinieria e veçorive
Përzgjedhja dhe inxhinieria e veçorive kanë rol kyç në performancën e modelit. Scikit-Learn ofron mjete që i lehtësojnë këto hapa.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Interpretueshmëria e modelit
Sidomos te modele si pemët e vendimit, është e rëndësishme të kuptojmë si i merr modeli vendimet e tij.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()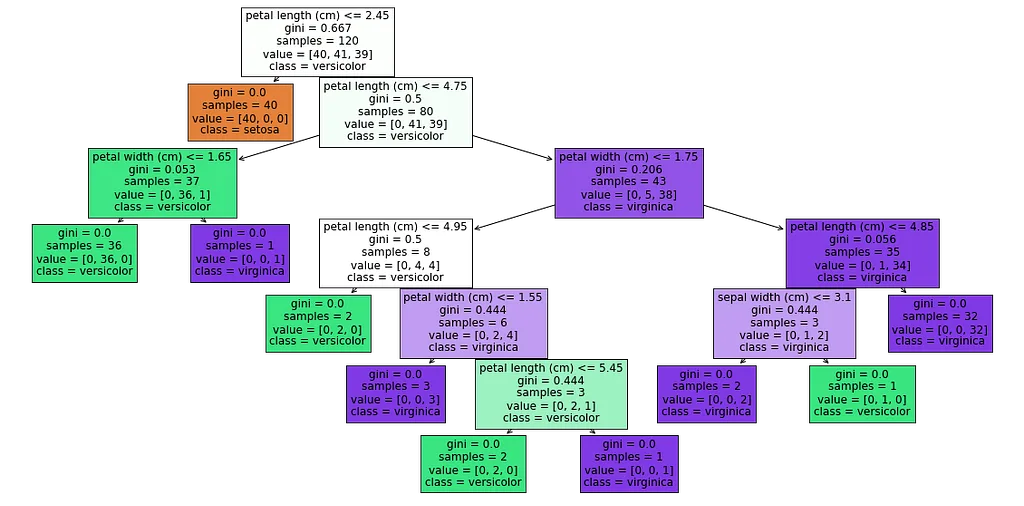
Grafiku tregon pemën e vendimit të një klasifikuesi të trajnuar me grupin e të dhënave Iris. Pema i ndan klasat setosa, versicolor dhe virginica me disa rregulla:
- Nyja rrënjë: kushti petal length ≤ 2,45 cm; Gini 0,667; 120 shembuj, ndarja [40, 41, 39]. Këtu klasat janë më të përziera.
- Nyja bijë e majtë: Gini 0,0; të 40 shembujt janë setosa. Një rregull i vetëm e veçon plotësisht setosën.
- Nyja bijë e djathtë (petal length > 2,45 cm): Gini 0,5; 80 shembuj, ndarja [0, 41, 39]. Versicolor dhe virginica janë ende të përziera.
- Ndarje më e imët: kushti petal length ≤ 4,75 cm; Gini 0,206; 43 shembuj, ndarja [0, 5, 38], kryesisht virginica.
- Nyjet më poshtë: kushti petal width ≤ 1,75 cm; Gini 0,0; të 35 shembujt janë virginica.
Çdo nyje tregon koeficientin Gini, numrin e shembujve dhe ndarjen e klasave, kështu që mund të ndiqni saktë cilën veçori përdor modeli në cilën pikë dhe si vendos.
Metodat e ansamblit
Metodat e ansamblit kombinojnë disa modele për të bërë parashikime më të forta. Random Forest është ndër më të njohurat.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Metrikat e vlerësimit
Përtej saktësisë, kanë rëndësi edhe metrika të tjera vlerësimi.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)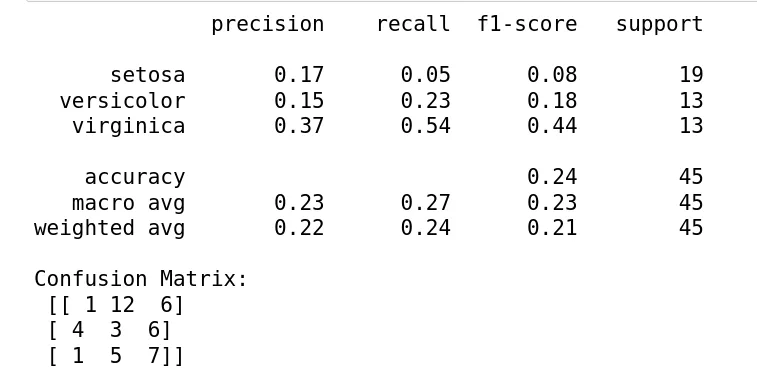
Këto rezultate tregojnë performancën e një modeli të trajnuar me të dhënat e përziera më sipër:
- Precizioni (precision), pjesa e parashikimeve pozitive që janë të sakta: setosa 17 %, versicolor 15 %, virginica 37 %.
- Rikujtimi (recall), pjesa e pozitivëve realë që gjenden: setosa 5 %, versicolor 23 %, virginica 54 %.
- Rezultati F1, mesatarja harmonike e precizionit dhe rikujtimit: setosa 0,08, versicolor 0,18, virginica 0,44.
- Saktësia e përgjithshme: 24 %.
- Mesatarja makro: precizioni 23 %, rikujtimi 27 %, F1 23 %. Mesatarja e peshuar: precizioni 22 %, rikujtimi 24 %, F1 21 %.
Në matricën e konfuzionit, 1 shembull setosa parashikohet saktë, 12 si versicolor dhe 6 si virginica; te versicolor 3 parashikohen saktë, 4 si setosa dhe 6 si virginica; te virginica 7 saktë, 1 si setosa dhe 5 si versicolor.
Interpretimi dhe sugjerimet
Performanca e përgjithshme është e ulët; virginica del më mirë, por ende jo mjaftueshëm mirë. Siç shpjegon shënimi i korrigjimit më sipër, shkaku kryesor janë etiketat e ngatërruara. Përveç kësaj, këta hapa zakonisht e përmirësojnë performancën:
- Provoni modele më të forta si Random Forest ose SVM dhe rregulloni hiperparametrat e tyre
- Shtoni veçori të reja ose transformoni ato ekzistuese
- Balanconi klasat me metoda si SMOTE, nëse janë të pabalancuara
- Përdorni validimin e kryqëzuar për të dalluar mbipërshtatjen ose nënpërshtatjen
Një zbatim në praktikë: segmentimi i klientëve
Si zbatim në praktikë, le të marrim segmentimin e klientëve për një kompani tregtie elektronike.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Pipeline-t në Scikit-Learn
Një pipeline lidh hapat e parapërpunimit dhe të trajnimit të modelit, duke e bërë kodin më të pastër dhe më efikas.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Rast studimi: klasifikimi me grupin e të dhënave Iris
Në këtë rast studimi zbatojmë disa algoritme të mësimit automatik mbi grupin e të dhënave Iris dhe krahasojmë rezultatet.
Përgatitja e të dhënave
Fillimisht ngarkojmë grupin e të dhënave dhe e ndajmë në grupin e trajnimit dhe atë të testimit.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Zbatimi dhe krahasimi i algoritmeve
Tani zbatojmë regresionin logjistik, një pemë vendimi dhe KNN dhe krahasojmë rezultatet e tyre.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Përfundim
Në këtë artikull kaluam nëpër fazat e një procesi pune të mësimit automatik me Scikit-Learn dhe pamë si zbatohen ato. Përdorëm algoritme të mbikëqyrura dhe të pambikëqyrura mbi grupin e të dhënave Iris dhe, përtej algoritmeve bazë, trajtuam optimizimin, vlerësimin dhe interpretimin, një zbatim në praktikë dhe pipeline-t. Me gamën e gjerë të mjeteve që ofron, Scikit-Learn ua lehtëson shkencëtarëve të të dhënave dhe praktikuesve të mësimit automatik zgjidhjen e problemeve komplekse.
Burimet
- Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Dokumentacioni i Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. dhe Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. dhe Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. dhe Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. dhe Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.