

Python за анализа на податоци: машинско учење со Scikit-Learn
Автор Yasin TANIŞ
Вовед
Машинското учење е научна област што им овозможува на компјутерите да учат од податоци и да предвидуваат, и денес се користи во многу дејности. Во оваа статија го разгледуваме Scikit-Learn, една од најкористените Python библиотеки за изработка на апликации за машинско учење.
Што е Scikit-Learn
Scikit-Learn е библиотека за машинско учење што нуди едноставни и ефикасни алатки за Python. Содржи алгоритми и за надгледувано и за ненадгледувано учење.
Инсталирање
Пред да започнеме, библиотеката треба да се инсталира. Ако сè уште ја немате на системот, инсталирајте ја со оваа команда:
pip install scikit-learnЗабелешка: примерите се намерно едноставни за да ги илустрираат поимите; не секогаш претставуваат најдобра метрика или најдобар метод за секое сценарио.
Надгледувано учење
Надгледуваното учење работи со означени податоци: исходите (ознаките) на примерите се познати, па моделот може да научи да ги предвидува.
Логистичка регресија
Логистичката регресија е често користен алгоритам за класификациски проблеми.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Овој код ја вчитува збирката Iris, ја дели на карактеристики и цел, го обучува моделот и ја печати неговата точност.
Дрва на одлучување
Дрвата на одлучување се моќен алгоритам и за класификација и за регресија.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Ненадгледувано учење
Ненадгледуваното учење не користи означени податоци; моделот сам се обидува да ја научи структурата на податоците.
Кластерирање K-Means
K-Means е често користен алгоритам за кластерирање што ги дели податоците во k кластери.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()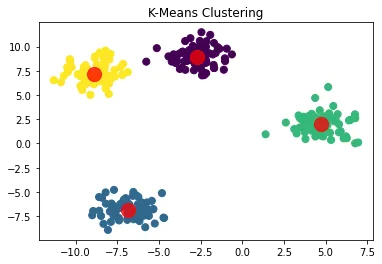
Анализа на главни компоненти (PCA)
PCA е техника за сведување на повеќедимензионални податоци на помалку димензии.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()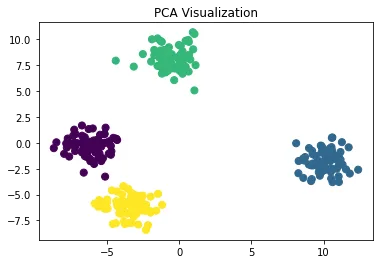
Подесување хиперпараметри
Подесувањето хиперпараметри е важен чекор за моделот да даде најдобри резултати. Класата GridSearchCV на Scikit-Learn го олеснува тоа.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Ознаките во излезот се на турски бидејќи изворниот код така ги печати: „најдобри параметри“ и „најдобар резултат“.)
Вкрстена валидација
Вкрстената валидација е важна техника за мерење колку добро моделот генерализира на нови податоци.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Забелешка за исправка: ниските резултати овде потекнуваат од претходниот чекор, а не од моделот. Кодот за повторно земање примероци случајно ги меша редовите во X, но ознаките во y не ги меша на ист начин, па ознаките повеќе не одговараат на редовите и моделот паѓа на ниво на случајност (околу 0,33 кај три класи). Ако тој чекор се прескокне или X и y се избираат со исти индекси, резултатите повторно растат. Метриките и резултатот од pipeline подолу се ниски од истата причина, бидејќи ги користат истите податоци.
Избор и инженеринг на карактеристики
Изборот и инженерингот на карактеристики имаат клучна улога во перформансите на моделот. Scikit-Learn нуди алатки што ги олеснуваат овие чекори.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Толкување на моделот
Особено кај модели како дрвата на одлучување, важно е да се разбере како моделот носи одлуки.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()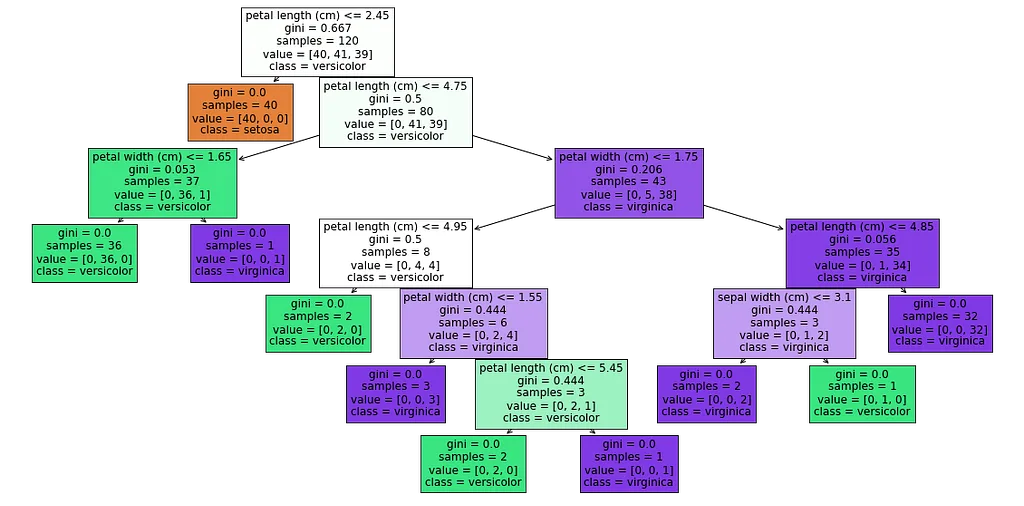
Графиконот го прикажува дрвото на одлучување на класификатор обучен на збирката Iris. Дрвото со неколку правила ги раздвојува класите setosa, versicolor и virginica:
- Коренски јазол: услов petal length ≤ 2,45 cm; Gini 0,667; 120 примероци, распределба [40, 41, 39]. Овде класите се најизмешани.
- Лев подјазол: Gini 0,0; сите 40 примероци се setosa. Едно правило целосно ја издвојува setosa.
- Десен подјазол (petal length > 2,45 cm): Gini 0,5; 80 примероци, распределба [0, 41, 39]. Versicolor и virginica сè уште се измешани.
- Пофина поделба: услов petal length ≤ 4,75 cm; Gini 0,206; 43 примероци, распределба [0, 5, 38], претежно virginica.
- Пониски јазли: услов petal width ≤ 1,75 cm; Gini 0,0; сите 35 примероци се virginica.
Секој јазол ги прикажува Gini коефициентот, бројот на примероци и распределбата на класите, па точно се гледа која карактеристика ја користи моделот во која точка и како одлучува.
Ансамбл методи
Ансамбл методите комбинираат повеќе модели за посилни предвидувања. Random Forest е еден од најпопуларните.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Метрики за вреднување
Освен точноста, важни се и други метрики за вреднување.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)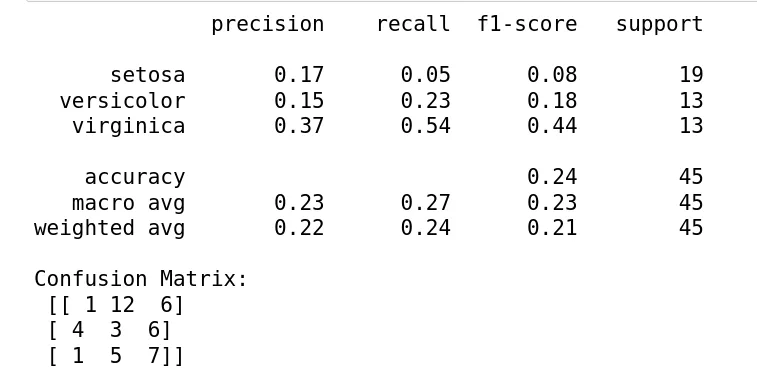
Овие резултати ги покажуваат перформансите на модел обучен на измешаните податоци од погоре:
- Прецизност, удел на точните меѓу позитивните предвидувања: setosa 17 %, versicolor 15 %, virginica 37 %.
- Одзив, удел на пронајдените меѓу вистински позитивните примероци: setosa 5 %, versicolor 23 %, virginica 54 %.
- F1 резултат, хармониска средина на прецизноста и одзивот: setosa 0,08, versicolor 0,18, virginica 0,44.
- Вкупна точност: 24 %.
- Макро просек: прецизност 23 %, одзив 27 %, F1 23 %. Пондериран просек: прецизност 22 %, одзив 24 %, F1 21 %.
Во матрицата на конфузија, 1 примерок setosa е предвиден точно, 12 како versicolor и 6 како virginica; кај versicolor 3 точно, 4 како setosa и 6 како virginica; кај virginica 7 точно, 1 како setosa и 5 како versicolor.
Толкување и предлози
Вкупните перформанси се ниски; најдобра е virginica, но ни таа не е доволно добра. Како што објаснува забелешката за исправка погоре, главната причина се измешаните ознаки. Освен тоа, овие чекори генерално ги подобруваат перформансите:
- Да се пробаат посилни модели како Random Forest или SVM и да се подесат хиперпараметрите
- Да се додадат нови карактеристики или да се трансформираат постојните
- Да се урамнотежат класите со методи како SMOTE ако се неурамнотежени
- Да се користи вкрстена валидација за да се забележи преприлагодување (overfitting) или недоволно прилагодување (underfitting)
Примена во пракса: сегментација на купувачи
Како примена во пракса да ја земеме сегментацијата на купувачи на една компанија за е-трговија.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Scikit-Learn pipeline
Pipeline ги поврзува чекорите на претходна обработка и обука на моделот, па кодот е почист и поефикасен.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Студија на случај: класификација со збирката Iris
Во оваа студија применуваме повеќе алгоритми за машинско учење врз збирката Iris и ги споредуваме резултатите.
Подготовка на податоците
Прво ја вчитуваме збирката и ја делиме на множество за обука и множество за тестирање.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Примена и споредба на алгоритмите
Сега применуваме логистичка регресија, дрво на одлучување и KNN и ги споредуваме резултатите.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Заклучок
Во оваа статија поминавме низ фазите на процесот на машинско учење со Scikit-Learn и видовме како се применуваат. Надгледуваните и ненадгледуваните алгоритми ги применивме врз збирката Iris, а покрај основните алгоритми ги обработивме оптимизацијата, вреднувањето и толкувањето, примената во пракса и pipeline. Благодарение на широкиот збир алатки, Scikit-Learn им го олеснува решавањето сложени проблеми на податочните научници и практичарите на машинско учење.
Извори
- Pedregosa, F. и др. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Документација на Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. и Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. и Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. и Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. и Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.