

Python ile Veri Analizi: Scikit-Learn ile Makine Öğrenimi
Yazan Yasin TANIŞ
Giriş
Makine öğrenimi, bilgisayarların veriden öğrenmesini ve tahmin yapmasını sağlayan bir bilim dalıdır ve bugün pek çok sektörde kullanılıyor. Bu yazıda, Python ile makine öğrenimi uygulamaları geliştirmek için en çok kullanılan kütüphanelerden biri olan Scikit-Learn'ü inceliyoruz.
Scikit-Learn nedir
Scikit-Learn, Python için basit ve verimli araçlar sunan bir makine öğrenimi kütüphanesidir. Hem denetimli hem de denetimsiz öğrenme algoritmaları içerir.
Kurulum
Kullanmaya başlamadan önce kütüphaneyi kurmamız gerekiyor. Sisteminizde yüklü değilse şu komutla kurabilirsiniz:
pip install scikit-learnNot: Buradaki örnekler kavramları göstermek için bilerek basit tutuldu; her senaryo için en iyi ölçüt ya da yöntem değildir.
Denetimli öğrenme
Denetimli öğrenme etiketli verilerle çalışır: modelin tahmin yapmayı öğrenebilmesi için veri setindeki örneklerin sonuçları (etiketleri) bilinir.
Lojistik regresyon
Lojistik regresyon, sınıflandırma problemlerinde yaygın olarak kullanılan bir algoritmadır.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Bu kod Iris veri setini yükler, veriyi özellikler ve hedef olarak ayırır, modeli eğitir ve doğruluğunu yazdırır.
Karar ağaçları
Karar ağaçları hem sınıflandırma hem de regresyon problemlerinde kullanılabilen güçlü bir algoritmadır.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Denetimsiz öğrenme
Denetimsiz öğrenme etiketli veri kullanmaz; model verinin yapısını kendisi öğrenmeye çalışır.
K-Means kümeleme
K-Means, veriyi k sayıda kümeye ayırmak için kullanılan yaygın bir kümeleme algoritmasıdır.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()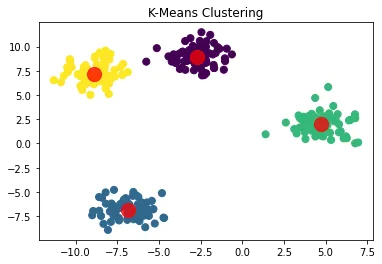
Temel bileşen analizi (PCA)
PCA, yüksek boyutlu veriyi daha az boyuta indirgemek için kullanılan bir tekniktir.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()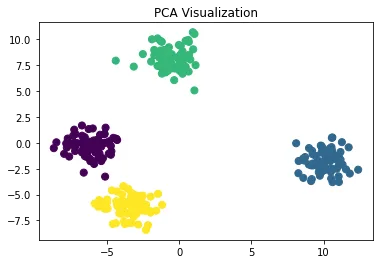
Hiperparametre ayarı
Hiperparametre ayarı, model performansını en iyi hâle getirmek için önemli bir adımdır. Scikit-Learn'ün GridSearchCV sınıfı bu işi kolaylaştırır.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334Çapraz doğrulama
Çapraz doğrulama, modelin yeni veriye ne kadar iyi genelleştiğini ölçmek için kullanılan önemli bir tekniktir.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Düzeltme notu: Buradaki düşük skorlar modelden değil, bir önceki adımdan kaynaklanıyor. Yeniden örnekleme kodu X'in satırlarını rastgele karıştırıyor ama y etiketlerini aynı sırayla karıştırmıyor; etiketler satırlarla eşleşmediği için model şans düzeyine (üç sınıfta yaklaşık 0,33) iniyor. Bu adım atlanırsa ya da X ve y aynı indekslerle seçilirse skorlar yeniden yükselir. Aşağıdaki metrik ve pipeline sonuçları da aynı veriyle üretildiği için düşük çıkıyor.
Özellik seçimi ve mühendisliği
Özellik seçimi ve mühendisliği, model performansını artırmada kritik rol oynar. Scikit-Learn bu süreçleri kolaylaştıran araçlar sunar.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Modelin yorumlanabilirliği
Özellikle karar ağaçları gibi modellerde, modelin kararlarını nasıl verdiğini anlamak önemlidir.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()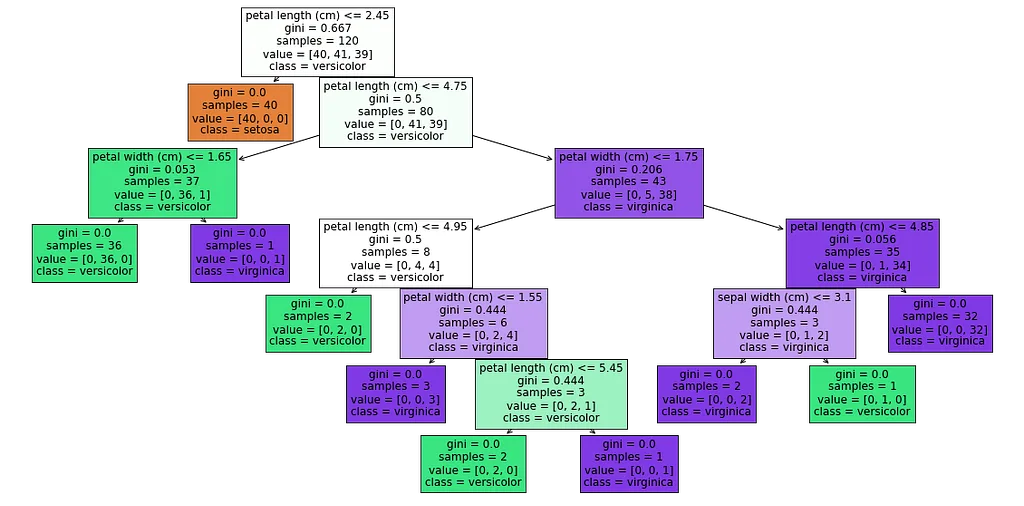
Bu grafik, Iris veri setine dayalı bir sınıflandırma modelinin karar ağacını gösteriyor. Ağaç, belirli kurallara göre setosa, versicolor ve virginica sınıflarını birbirinden ayırıyor:
- Kök düğüm: koşul petal length ≤ 2.45 cm; Gini 0.667; 120 örnek, dağılım [40, 41, 39]. Sınıflar burada en karışık hâlde.
- Sol alt düğüm: Gini 0.0; 40 örneğin hepsi setosa. Setosa tek bir kuralla tamamen ayrılıyor.
- Sağ alt düğüm (petal length > 2.45 cm): Gini 0.5; 80 örnek, dağılım [0, 41, 39]. Versicolor ve virginica burada hâlâ karışık.
- Daha ayrıntılı ayrım: koşul petal length ≤ 4.75 cm; Gini 0.206; 43 örnek, dağılım [0, 5, 38], çoğunluk virginica.
- Alt düğümler: koşul petal width ≤ 1.75 cm; Gini 0.0; 35 örneğin hepsi virginica.
Her düğümde Gini katsayısı, örnek sayısı ve sınıf dağılımı görülebiliyor. Böylece modelin hangi noktada hangi özelliği kullandığı ve kararlarını nasıl verdiği açıkça izlenebiliyor.
Topluluk yöntemleri
Topluluk (ensemble) yöntemleri birden fazla modeli birleştirerek daha güçlü tahminler yapar. Random Forest bunların en popülerlerinden biridir.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Değerlendirme metrikleri
Doğruluğun ötesinde başka değerlendirme metrikleri de önemlidir.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)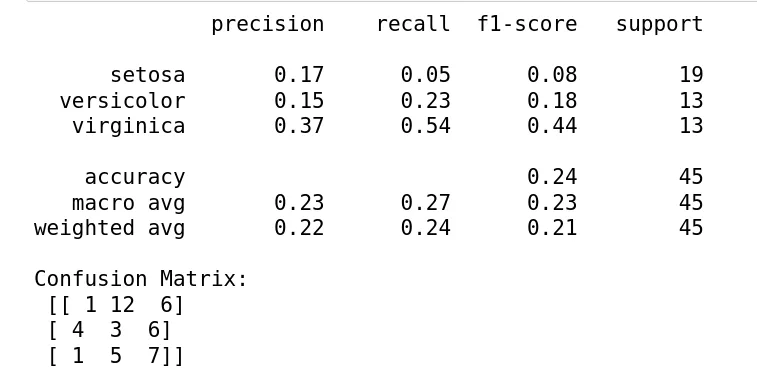
Bu sonuçlar, yukarıdaki karıştırılmış veriyle eğitilen modelin performansını gösteriyor:
- Kesinlik (precision), yani pozitif tahminlerin ne kadarının doğru olduğu: setosa %17, versicolor %15, virginica %37.
- Duyarlılık (recall), yani gerçek pozitiflerin ne kadarının yakalandığı: setosa %5, versicolor %23, virginica %54.
- F1 skoru, kesinlik ve duyarlılığın harmonik ortalaması: setosa 0.08, versicolor 0.18, virginica 0.44.
- Genel doğruluk: %24.
- Makro ortalama: kesinlik %23, duyarlılık %27, F1 %23. Ağırlıklı ortalama: kesinlik %22, duyarlılık %24, F1 %21.
Karışıklık matrisine göre setosa örneklerinin 1'i doğru, 12'si versicolor ve 6'sı virginica olarak tahmin edilmiş; versicolor'da 3 doğru, 4 setosa ve 6 virginica; virginica'da 7 doğru, 1 setosa ve 5 versicolor var.
Yorum ve iyileştirme önerileri
Genel performans düşük; en iyi sonuç virginica sınıfında, ama o da yeterli değil. Yukarıdaki düzeltme notunda açıklandığı gibi asıl neden etiketlerin karışmış olması. Bunun dışında genel olarak şu adımlar performansı artırabilir:
- Daha güçlü modeller (Random Forest, SVM gibi) denemek ve hiperparametreleri ayarlamak
- Yeni özellikler eklemek veya mevcut özellikleri dönüştürmek
- Sınıflar dengesizse SMOTE gibi yöntemlerle dengelemek
- Aşırı ya da eksik öğrenmeyi fark etmek için çapraz doğrulama kullanmak
Gerçek dünya uygulaması: müşteri segmentasyonu
Gerçek bir uygulama olarak bir e-ticaret şirketinin müşteri segmentasyonu problemini ele alalım.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Scikit-Learn Pipeline
Pipeline, veri ön işleme ve model eğitimi adımlarını birleştirerek daha temiz ve verimli kod yazmayı sağlar.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Örnek olay: Iris veri setiyle sınıflandırma
Bu örnek olayda Iris veri seti üzerinde farklı makine öğrenimi algoritmalarını uygulayıp sonuçlarını karşılaştırıyoruz.
Veri hazırlığı
Önce veri setini yükleyip eğitim ve test setlerine ayıralım.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Algoritmaları uygulama ve karşılaştırma
Lojistik regresyon, karar ağacı ve KNN algoritmalarını uygulayıp sonuçlarını karşılaştıralım.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Sonuç
Bu yazıda Scikit-Learn ile makine öğrenimi sürecinin çeşitli aşamalarını inceledik ve nasıl uygulanabileceğini gördük. Denetimli ve denetimsiz öğrenme algoritmalarını Iris veri seti üzerinde uyguladık. Temel algoritmaların yanı sıra model optimizasyonunu, değerlendirmeyi ve yorumlamayı ele aldık; gerçek dünya uygulamasına ve pipeline kullanımına da değindik. Scikit-Learn, veri bilimcilere ve makine öğrenimi uygulayıcılarına geniş bir araç seti sunarak karmaşık problemleri çözmeyi kolaylaştırıyor.
Kaynakça
- Pedregosa, F. vd. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Scikit-Learn belgeleri: scikit-learn.org
- Hastie, T., Tibshirani, R. ve Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. ve Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. ve Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. ve Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.