

Análisis de datos con pandas: manipular y visualizar datos
Escrito por Yasin TANIŞ
Introducción
El análisis de datos se ha convertido en una parte esencial de la toma de decisiones. Python destaca en este campo gracias a sus potentes bibliotecas de análisis y manipulación de datos. Una de ellas, pandas, es indispensable para los científicos de datos porque es flexible y fácil de usar. En este artículo vemos las funciones principales de pandas y cómo se usa en el análisis de datos, con ejemplos prácticos sobre datos reales o sintéticos.
DataFrame y Series
Pandas trabaja con dos estructuras de datos principales. Un DataFrame es una estructura bidimensional de filas y columnas. Una Series es unidimensional y representa una sola columna de datos.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)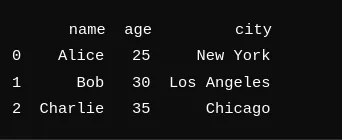
Crear DataFrames
Hay muchas formas de crear un DataFrame. Puede cargar datos de fuentes como CSV, Excel y SQL y convertirlos en un DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Cargar y guardar datos
Pandas simplifica la carga y el guardado de datos. Puede leer y procesar archivos en muchos formatos.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Limpiar y preparar los datos
La limpieza y la preparación son pasos críticos del análisis de datos. Pandas facilita el manejo de valores ausentes, la conversión de tipos de datos y la eliminación de los datos que no necesita.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])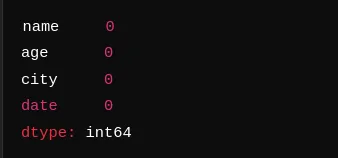
Aquí comprobamos si el DataFrame tiene valores ausentes. La salida muestra que ninguna columna los tiene.
Resúmenes estadísticos
Pandas ofrece muchas herramientas para resumir datos con rapidez. Las estadísticas y los resúmenes básicos se obtienen con una sola llamada.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())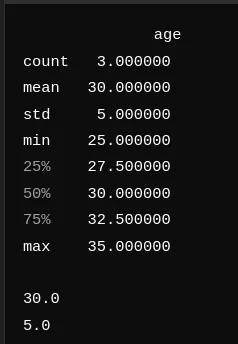
En el resumen, la edad media es 30 con una desviación típica de 5; las edades mínima y máxima son 25 y 35. Esto da una idea rápida de la distribución de edades en los datos.
Agrupar y resumir
Agrupar y resumir es uno de los puntos fuertes de pandas. Las funciones groupby y pivot_table lo hacen sencillo.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)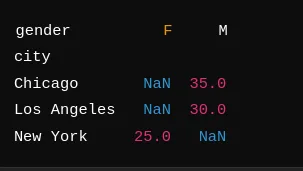
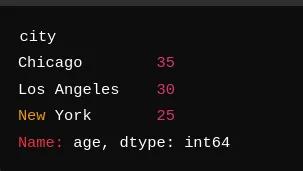
Al agrupar por ciudad obtenemos la edad media de cada una: Chicago (35), Los Ángeles (30) y Nueva York (25). La tabla dinámica ofrece un resumen parecido desglosado por género; nuestro ejemplo no tiene datos de género, por eso esas celdas muestran NaN.
Visualizar datos con pandas
Pandas tiene herramientas gráficas sencillas pero eficaces. Funciones como plot, hist y boxplot crean gráficos rápidamente.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Trabajar con Seaborn y Matplotlib
También puede visualizar datos de pandas con Seaborn y Matplotlib, que permiten gráficos más personalizados y detallados.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Análisis de series temporales
Pandas maneja muy bien los datos de series temporales, lo que facilita encontrar tendencias y patrones.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())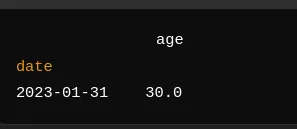
Aquí convertimos la columna date a datetime y la fijamos como índice. Al remuestrear por mes y calcular la media obtenemos una edad media de 30 para enero de 2023.
Fusionar y combinar datos
Pandas ofrece muchas funciones para fusionar y combinar conjuntos de datos, como merge, join y concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)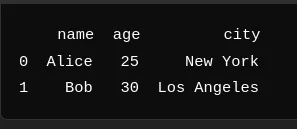
En este ejemplo fusionamos dos DataFrames por la columna name, uniendo la edad y la ciudad de cada persona.
Ejemplo práctico: análisis con datos sintéticos
Crear los datos
Para un ejemplo práctico creamos datos sintéticos para mostrar lo que puede hacer pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())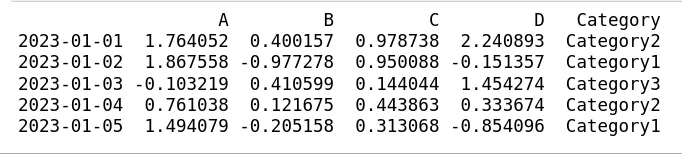
Así se crea un DataFrame de 100 filas con las columnas A, B, C y D y una columna categórica Category. Los valores son aleatorios y Category toma uno de tres valores.
Análisis y visualización
Con los datos sintéticos hacemos algunos análisis básicos y dibujamos gráficos.
# Statistical summary
print(df.describe())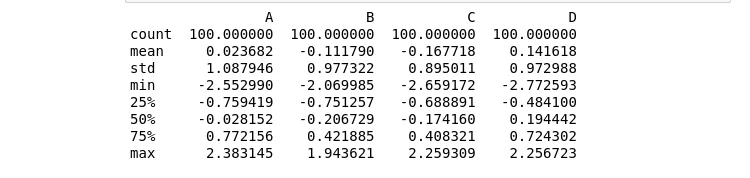
El resumen ofrece una visión completa de los datos. Las medias de las columnas A, B, C y D están cerca de cero, como cabe esperar de una distribución normal aleatoria, y las desviaciones típicas están cerca de 1, lo que muestra cuánto se dispersan los valores alrededor de la media.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)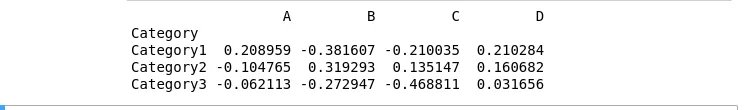
Agrupar por Category muestra la media de cada columna para cada categoría y revela en qué se diferencian las categorías.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()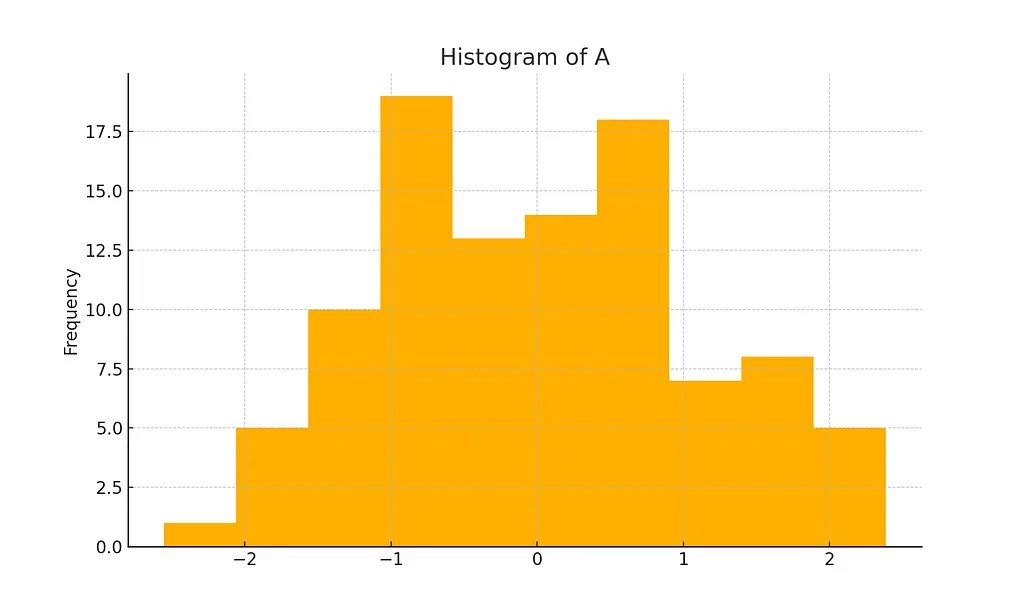
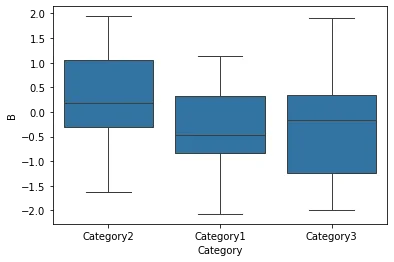
El histograma muestra la distribución de los valores de la columna A y el diagrama de caja, la columna B por categorías. Gráficos así ayudan a entender la distribución y a detectar valores atípicos o patrones.
Conclusión
Pandas es una herramienta versátil y potente para el análisis de datos; su flexibilidad y facilidad de uso la hacen indispensable para los científicos de datos. En este artículo hemos visto sus funciones principales y cómo encajan en un análisis, y hemos mostrado un uso práctico con datos sintéticos. Con más práctica y técnicas más avanzadas, puede profundizar en la ciencia de datos y extraer más información de sus datos con pandas.
Referencias
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2.ª ed.). O’Reilly Media.
- El equipo de desarrollo de pandas. Documentación de pandas. pandas.pydata.org
- Documentación de NumPy. numpy.org
- Documentación de Matplotlib. matplotlib.org
- Documentación de Seaborn. seaborn.pydata.org