

Analiza podataka pomoću pandasa: obrada i vizualizacija podataka
Autor Yasin TANIŞ
Uvod
Analiza podataka postala je nezaobilazan dio donošenja odluka. Python se u toj oblasti ističe zahvaljujući moćnim bibliotekama za analizu i obradu podataka. Jedna od njih, pandas, nezamjenjiva je stručnjacima za nauku o podacima jer je fleksibilna i jednostavna za upotrebu. U ovom članku razmatramo osnovne mogućnosti pandasa i njegovu upotrebu u analizi podataka, uz praktične primjere na stvarnim ili sintetičkim podacima.
DataFrame i Series
Pandas radi s dvije osnovne strukture podataka. DataFrame je dvodimenzionalna struktura sastavljena od redova i kolona. Series je jednodimenzionalna i predstavlja jednu kolonu podataka.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)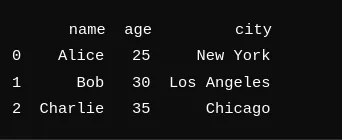
Kreiranje DataFrame-a
DataFrame se može napraviti na mnogo načina. Podatke možete učitati iz izvora kao što su CSV, Excel i SQL i pretvoriti ih u DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Učitavanje i spremanje podataka
Pandas pojednostavljuje učitavanje i spremanje podataka. Možete čitati i obrađivati datoteke u mnogo različitih formata.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Čišćenje i priprema podataka
Čišćenje i priprema ključni su koraci analize podataka. Pandas olakšava rad s nedostajućim vrijednostima, pretvaranje tipova podataka i uklanjanje nepotrebnih podataka.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])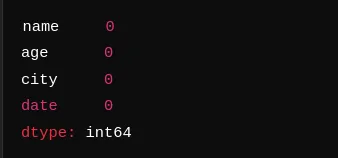
Ovdje provjeravamo ima li DataFrame nedostajućih vrijednosti. Izlaz pokazuje da ih nema ni u jednoj koloni.
Statistički sažeci
Pandas nudi mnogo alata za brzo sažimanje podataka. Osnovne statistike i sažeci dobijaju se jednim pozivom.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())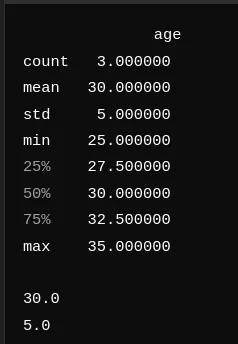
Prema sažetku, prosječna starost je 30 godina, a standardna devijacija 5; najmanja i najveća starost su 25 i 35 godina. To daje brz uvid u raspodjelu starosti u podacima.
Grupisanje i sažimanje
Grupisanje i sažimanje jedna je od jačih strana pandasa. Funkcije groupby i pivot_table to znatno olakšavaju.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)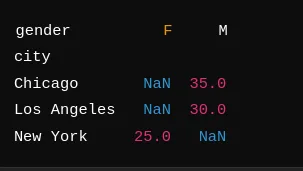
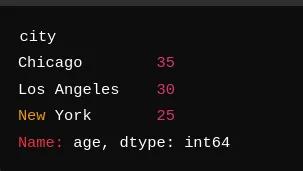
Grupisanjem po gradu dobijamo prosječnu starost za svaki grad: Chicago (35), Los Angeles (30) i New York (25). Pivot tabela daje sličan sažetak podijeljen po spolu; naš primjer nema podatke o spolu, pa te ćelije prikazuju NaN.
Vizualizacija podataka pomoću pandasa
Pandas ima jednostavne, ali djelotvorne alate za crtanje grafikona. Funkcije kao što su plot, hist i boxplot omogućavaju brzu izradu grafikona.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Rad sa Seabornom i Matplotlibom
Podatke iz pandasa možete vizualizirati i pomoću Seaborna i Matplotliba, koji omogućavaju prilagođenije i detaljnije grafikone.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Analiza vremenskih serija
Pandas vrlo dobro radi s vremenskim serijama, pa je lako uočiti trendove i obrasce.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())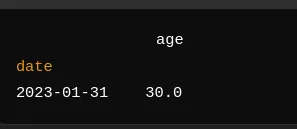
Ovdje kolonu date pretvaramo u datetime i postavljamo je kao indeks. Ponovnim uzorkovanjem po mjesecima i računanjem prosjeka dobijamo prosječnu starost od 30 godina za januar 2023.
Spajanje i kombiniranje podataka
Pandas ima mnogo funkcija za spajanje i kombiniranje skupova podataka, kao što su merge, join i concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)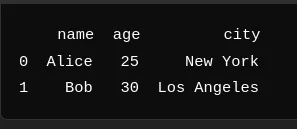
U ovom primjeru spajamo dva DataFrame-a po koloni name i objedinjujemo starost i grad svake osobe.
Praktičan primjer: analiza sintetičkih podataka
Kreiranje podataka
Za praktičan primjer pravimo sintetičke podatke kako bismo pokazali šta pandas može.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())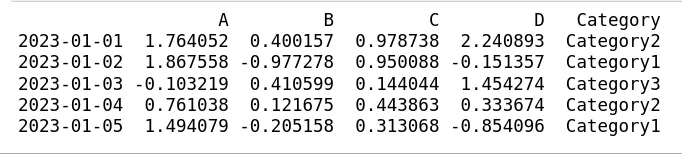
Na ovaj način pravi se DataFrame od 100 redova s kolonama A, B, C i D i kategorijskom kolonom Category. Vrijednosti su nasumične, a Category uzima jednu od tri vrijednosti.
Analiza i vizualizacija
Na sintetičkim podacima radimo osnovnu analizu i crtamo grafikone.
# Statistical summary
print(df.describe())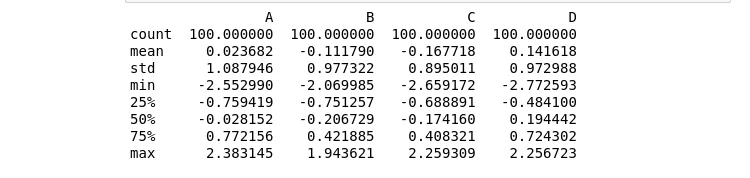
Sažetak daje potpun pregled podataka. Prosjeci kolona A, B, C i D blizu su nule, kako se i očekuje od nasumične normalne raspodjele, a standardne devijacije blizu su 1, što pokazuje koliko se vrijednosti rasipaju oko prosjeka.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)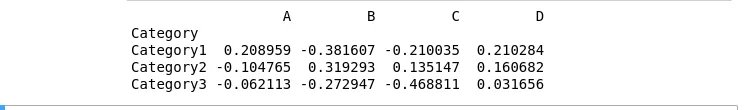
Grupisanje po koloni Category pokazuje prosjek svake kolone za svaku kategoriju i otkriva po čemu se kategorije razlikuju.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()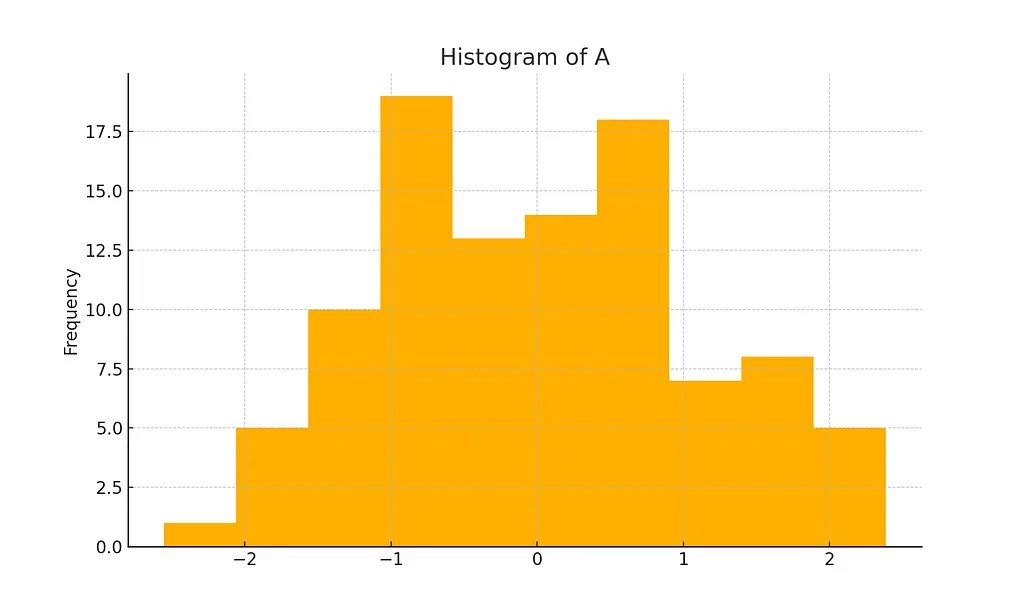
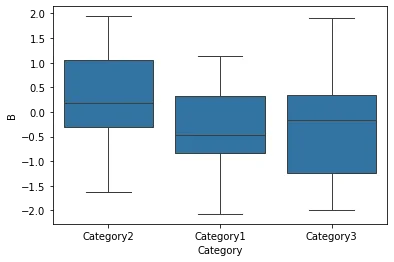
Histogram pokazuje raspodjelu vrijednosti u koloni A, a kutijasti dijagram prikazuje kolonu B po kategorijama. Ovakvi grafikoni pomažu da razumijete raspodjelu i uočite ekstremne vrijednosti ili obrasce.
Zaključak
Pandas je svestran i moćan alat za analizu podataka; fleksibilnost i jednostavnost upotrebe čine ga nezamjenjivim za stručnjake za nauku o podacima. U ovom članku obradili smo njegove osnovne mogućnosti i njihovo mjesto u analizi te pokazali praktičnu upotrebu na sintetičkim podacima. Uz dodatnu praksu i naprednije tehnike možete dublje ući u nauku o podacima i uz pandas izvući više uvida iz svojih podataka.
Izvori
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2. izd.). O’Reilly Media.
- Razvojni tim pandasa. Dokumentacija pandasa. pandas.pydata.org
- Dokumentacija NumPyja. numpy.org
- Dokumentacija Matplotliba. matplotlib.org
- Dokumentacija Seaborna. seaborn.pydata.org