

Анализа података уз Pandas: обрада и визуелизација података
Аутор Yasin TANIŞ
Увод
Анализа података постала је незаобилазан део доношења одлука. Python се у тој области истиче захваљујући моћним библиотекама за анализу и обраду података. Једна од њих, pandas, незаменљива је стручњацима за науку о подацима јер је флексибилна и лака за употребу. У овом тексту разматрамо основне могућности pandas-а и његову употребу у анализи података, уз практичне примере на стварним или синтетичким подацима.
DataFrame и Series
Pandas ради с две основне структуре података. DataFrame је дводимензионална структура састављена од редова и колона. Series је једнодимензионална и представља једну колону података.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)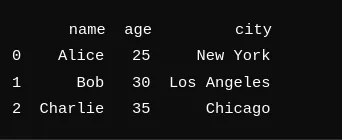
Креирање DataFrame-а
DataFrame се може направити на много начина. Податке можете учитати из извора као што су CSV, Excel и SQL и претворити их у DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Учитавање и чување података
Pandas поједностављује учитавање и чување података. Можете читати и обрађивати датотеке у много различитих формата.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Чишћење и припрема података
Чишћење и припрема кључни су кораци анализе података. Pandas олакшава рад с недостајућим вредностима, претварање типова података и уклањање непотребних података.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])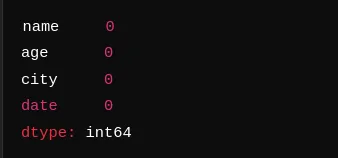
Овде проверавамо има ли DataFrame недостајућих вредности. Излаз показује да их нема ни у једној колони.
Статистички сажеци
Pandas нуди много алата за брзо сажимање података. Основни статистички показатељи и сажеци добијају се једним позивом.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())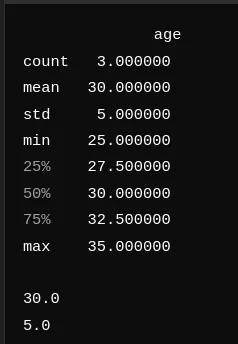
У сажетку је просечна старост 30, а стандардна девијација 5; најмања и највећа старост износе 25 и 35. То даје брз увид у расподелу старости у подацима.
Груписање и сажимање
Груписање и сажимање једна је од јачих страна pandas-а. Функције groupby и pivot_table то чине једноставним.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)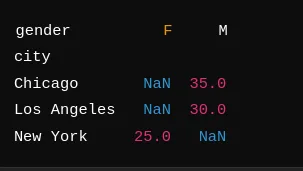
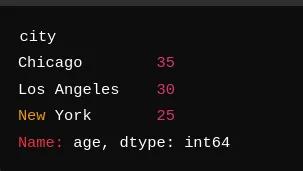
Груписањем по граду добијамо просечну старост за сваки: Чикаго (35), Лос Анђелес (30) и Њујорк (25). Пивот табела даје сличан сажетак подељен по полу; наш пример нема податке о полу, па те ћелије приказују NaN.
Визуелизација уз pandas
Pandas има једноставне, али делотворне алате за графиконе. Функције као што су plot, hist и boxplot омогућавају брзу израду графикона.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Рад са Seaborn-ом и Matplotlib-ом
Податке из pandas-а можете визуелизовати и уз Seaborn и Matplotlib, који омогућавају прилагођеније и детаљније графиконе.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Анализа временских серија
Pandas веома добро ради с временским серијама, па је лако уочити трендове и обрасце.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())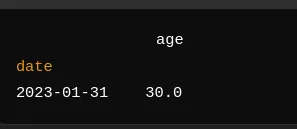
Овде колону date претварамо у datetime и постављамо је као индекс. Месечним поновним узорковањем и просеком добијамо просечну старост 30 за јануар 2023. године.
Спајање и комбиновање података
Pandas има много функција за спајање и комбиновање скупова података, као што су merge, join и concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)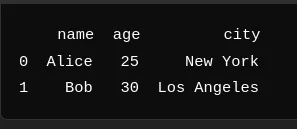
У овом примеру спајамо два DataFrame-а по колони name и обједињујемо старост и град сваке особе.
Практичан пример: анализа синтетичких података
Креирање података
За практичан пример правимо синтетичке податке да бисмо показали шта pandas може.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())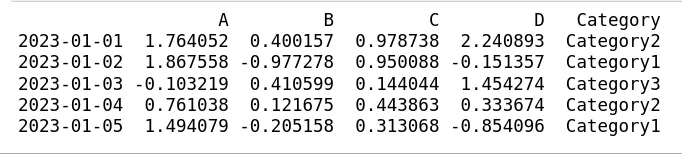
Овим се прави DataFrame од 100 редова с колонама A, B, C и D и категоријском колоном Category. Вредности су насумичне, а Category узима једну од три вредности.
Анализа и визуелизација
На синтетичким подацима радимо основну анализу и цртамо графиконе.
# Statistical summary
print(df.describe())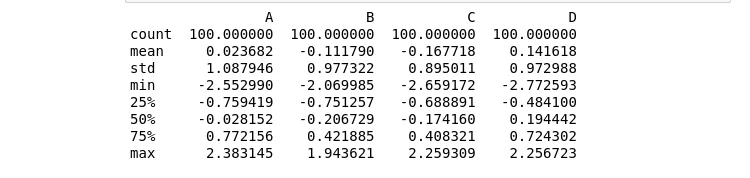
Сажетак даје потпун преглед података. Просеци колона A, B, C и D близу су нуле, како се и очекује од насумичне нормалне расподеле, а стандардне девијације близу су 1 и показују колико се вредности расипају око просека.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)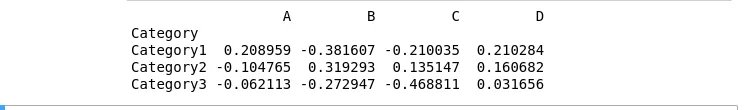
Груписање по Category показује просек сваке колоне за сваку категорију и открива по чему се категорије разликују.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()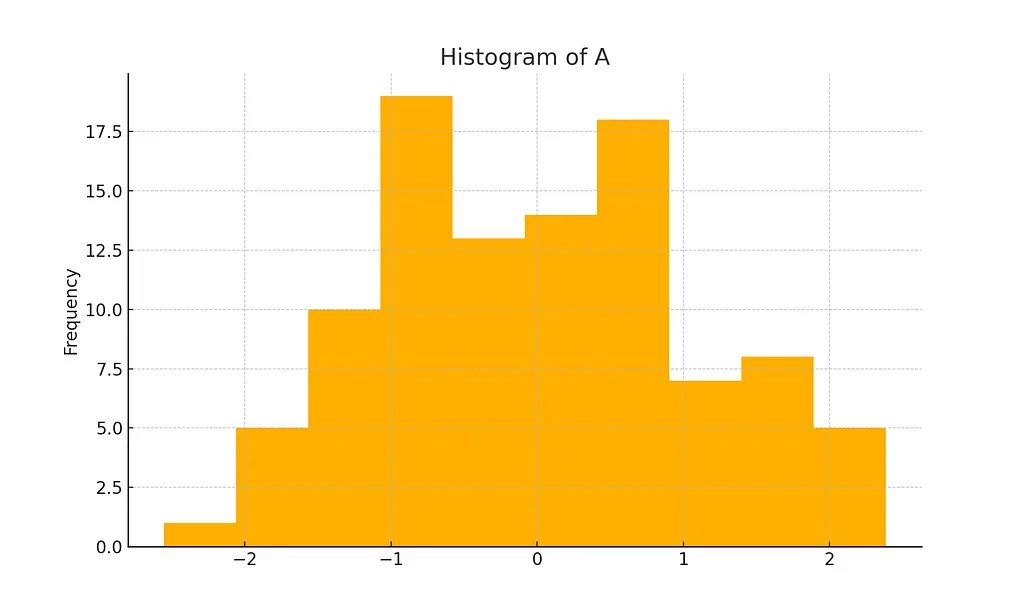
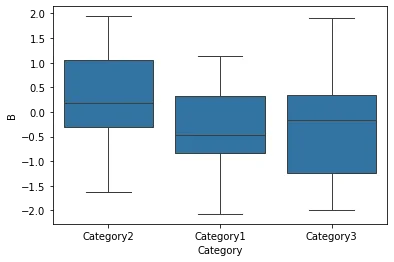
Хистограм показује расподелу вредности у колони A, а кутијасти дијаграм колону B по категоријама. Овакви графикони помажу да разумете расподелу и уочите одступајуће вредности или обрасце.
Закључак
Pandas је свестран и моћан алат за анализу података; флексибилност и лакоћа употребе чине га незаменљивим за стручњаке за науку о подацима. У овом тексту обрадили смо његове основне могућности и њихово место у анализи и показали практичну употребу на синтетичким подацима. Уз више вежбе и напредније технике можете дубље ући у науку о подацима и уз pandas извући више увида из својих података.
Извори
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2. изд.). O’Reilly Media.
- Развојни тим pandas-а. Документација pandas-а. pandas.pydata.org
- Документација NumPy-ја. numpy.org
- Документација Matplotlib-а. matplotlib.org
- Документација Seaborn-а. seaborn.pydata.org