

Pandas ile Veri Analizi: Veriyi İşleme ve Görselleştirme
Yazan Yasin TANIŞ
Giriş
Veri analizi, karar verme süreçlerinin ayrılmaz bir parçası hâline geldi. Python, veriyi analiz etmek ve işlemek için sunduğu güçlü kütüphanelerle bu alanda öne çıkıyor. Bunlardan biri olan pandas, esnekliği ve kullanım kolaylığı sayesinde veri bilimciler için vazgeçilmez. Bu yazıda pandas'ın temel özelliklerine ve veri analizinde nasıl kullanıldığına, gerçek ya da sentetik veriyle pratik örneklerle bakıyoruz.
DataFrame ve Series
Pandas iki temel veri yapısıyla çalışır. DataFrame, satır ve sütunlardan oluşan iki boyutlu bir yapıdır. Series ise tek boyutludur ve tek bir veri sütununu temsil eder.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)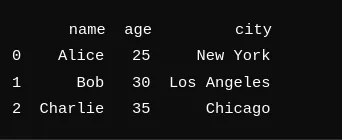
DataFrame oluşturma
DataFrame oluşturmanın pek çok yolu var. CSV, Excel ve SQL gibi kaynaklardan veri yükleyip DataFrame'e dönüştürebilirsiniz.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Veri yükleme ve kaydetme
Pandas veri yüklemeyi ve kaydetmeyi kolaylaştırır. Farklı biçimlerdeki dosyaları okuyup işleyebilirsiniz.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Veri temizleme ve hazırlama
Temizleme ve hazırlık, veri analizinin kritik adımlarıdır. Pandas eksik değerleri ele almayı, veri tiplerini dönüştürmeyi ve gereksiz veriyi ayıklamayı kolaylaştırır.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])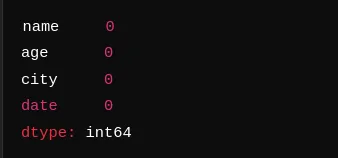
Burada DataFrame'de eksik değer olup olmadığını kontrol ediyoruz. Çıktı, hiçbir sütunda eksik değer olmadığını gösteriyor.
İstatistiksel özetler
Pandas veriyi hızla özetlemek için birçok araç sunar. Temel istatistikler ve özetler tek bir çağrıyla elde edilir.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())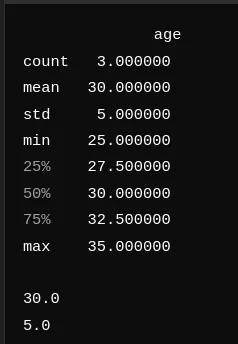
Özette ortalama yaş 30, standart sapma 5; en küçük ve en büyük yaşlar 25 ve 35. Bu, verideki yaş dağılımına hızlı bir bakış sağlıyor.
Gruplama ve özetleme
Gruplama ve özetleme pandas'ın güçlü yanlarından biri. groupby ve pivot_table fonksiyonları bunu kolaylaştırır.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)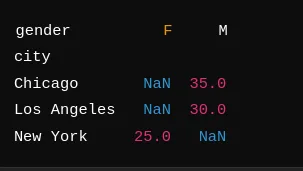
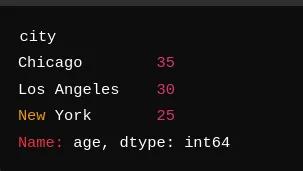
Şehre göre gruplayınca her şehrin ortalama yaşını görüyoruz: Chicago (35), Los Angeles (30) ve New York (25). Pivot tablo, cinsiyete göre ayrılmış benzer bir özet veriyor; örneğimizde cinsiyet verisi olmadığı için bu hücrelerde NaN görünüyor.
Pandas ile görselleştirme
Pandas'ın basit ama etkili grafik araçları var. plot, hist ve boxplot gibi fonksiyonlar hızla grafik üretir.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Seaborn ve Matplotlib ile birlikte
Pandas verisini, daha özelleştirilmiş ve ayrıntılı grafiklere imkân veren Seaborn ve Matplotlib ile de görselleştirebilirsiniz.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Zaman serisi analizi
Pandas zaman serisi verisiyle çok iyi çalışır; bu da eğilimleri ve örüntüleri bulmayı kolaylaştırır.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())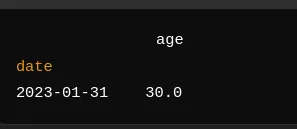
Burada date sütununu datetime biçimine çevirip dizin olarak ayarlıyoruz. Aylık yeniden örnekleyip ortalamayı alınca Ocak 2023 için ortalama yaş 30 çıkıyor.
Veri birleştirme
Pandas, veri setlerini birleştirmek için merge, join ve concat gibi birçok fonksiyon sunar.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)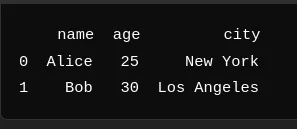
Bu örnekte iki DataFrame'i name sütunu üzerinden birleştirerek her kişinin yaşını ve şehrini bir araya getiriyoruz.
Uygulamalı örnek: sentetik veriyle analiz
Veriyi oluşturma
Pratik bir örnek için pandas'ın neler yapabildiğini gösterecek sentetik veri oluşturuyoruz.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())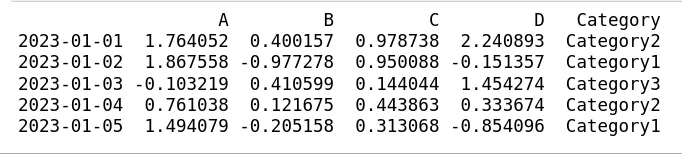
Bu kod A, B, C ve D sütunlarıyla ve Category adlı kategorik bir sütunla 100 satırlık bir DataFrame oluşturuyor. Değerler rastgele; Category üç değerden birini alıyor.
Analiz ve görselleştirme
Sentetik veriyle temel analizler yapıp grafikler çiziyoruz.
# Statistical summary
print(df.describe())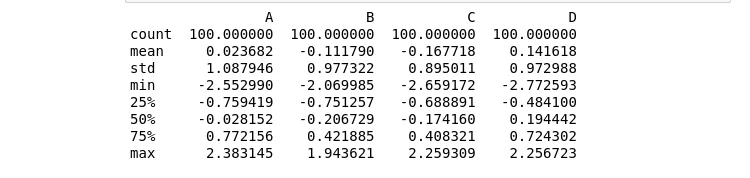
Özet, veriye kapsamlı bir bakış sunuyor. A, B, C ve D sütunlarının ortalamaları sıfıra yakın; rastgele normal dağılımdan beklenen de bu. Standart sapmalar 1'e yakın ve değerlerin ortalama etrafında ne kadar yayıldığını gösteriyor.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)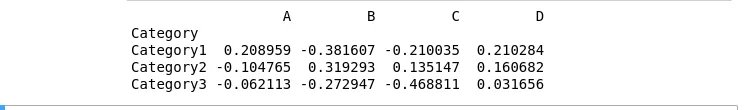
Category'ye göre gruplamak her kategori için sütun ortalamalarını gösteriyor ve kategorilerin nasıl ayrıştığını ortaya koyuyor.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()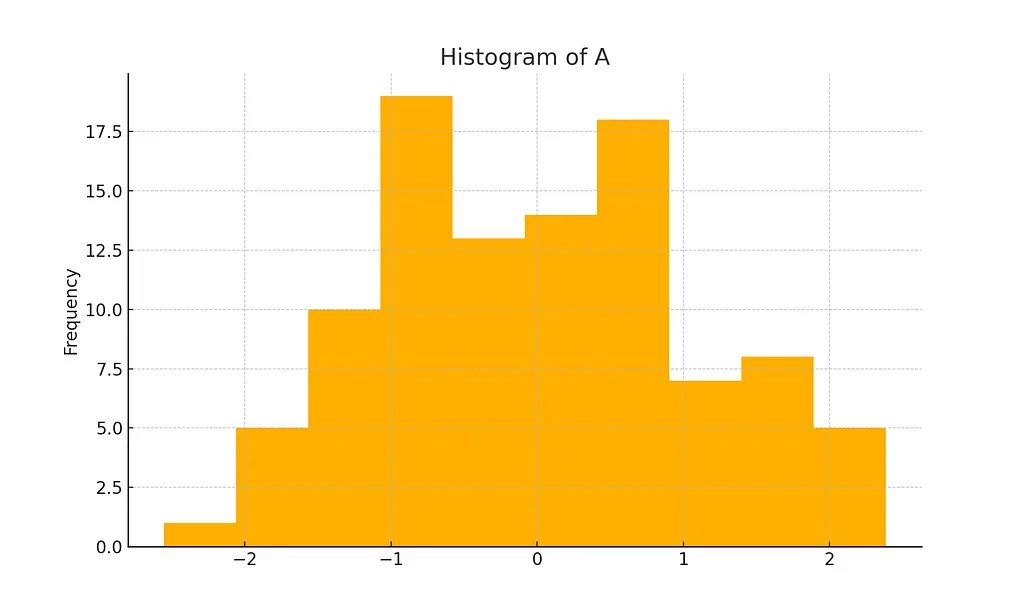
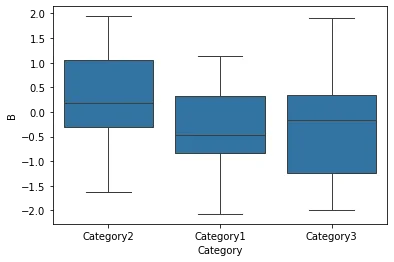
Histogram A sütunundaki değerlerin dağılımını, kutu grafiği ise B sütununun kategorilere göre dağılımını gösteriyor. Bu tür grafikler dağılımı anlamaya ve aykırı değerleri ya da örüntüleri fark etmeye yardımcı olur.
Sonuç
Pandas, veri analizi için çok yönlü ve güçlü bir araç; esnekliği ve kullanım kolaylığı onu veri bilimciler için vazgeçilmez kılıyor. Bu yazıda temel özelliklerini ve bir analizde nasıl yer aldıklarını ele aldık, sentetik veriyle pratik kullanımını gösterdik. Daha fazla pratik ve ileri tekniklerle veri bilimine daha derinden girebilir, pandas ile verinizden daha fazla içgörü çıkarabilirsiniz.
Kaynaklar
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2. baskı). O’Reilly Media.
- Pandas geliştirme ekibi. pandas belgeleri. pandas.pydata.org
- NumPy belgeleri. numpy.org
- Matplotlib belgeleri. matplotlib.org
- Seaborn belgeleri. seaborn.pydata.org