

Аналіз даних із Pandas: обробка та візуалізація даних
Автор: Yasin TANIŞ
Вступ
Аналіз даних став невід’ємною частиною ухвалення рішень. Python вирізняється в цій галузі завдяки потужним бібліотекам для аналізу й обробки даних. Одна з них — pandas — незамінна для фахівців із даних, бо вона гнучка й проста у використанні. У цій статті ми розглянемо основні можливості pandas і їх застосування в аналізі даних на практичних прикладах із реальними або синтетичними даними.
DataFrame і Series
Pandas працює з двома основними структурами даних. DataFrame — двовимірна структура з рядків і стовпців. Series — одновимірна структура, що представляє один стовпець даних.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)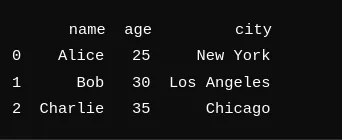
Створення DataFrame
Створити DataFrame можна багатьма способами. Дані можна завантажити з таких джерел, як CSV, Excel і SQL, і перетворити на DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Завантаження та збереження даних
Pandas спрощує завантаження й збереження даних. Можна читати й обробляти файли в багатьох форматах.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Очищення та підготовка даних
Очищення й підготовка — ключові етапи аналізу даних. Pandas спрощує роботу з пропущеними значеннями, перетворення типів даних і видалення непотрібних даних.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])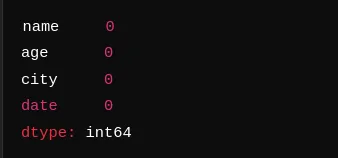
Тут ми перевіряємо, чи є в DataFrame пропущені значення. Виведення показує, що їх немає в жодному стовпці.
Статистичні зведення
Pandas пропонує багато інструментів для швидкого узагальнення даних. Базову статистику можна отримати одним викликом.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())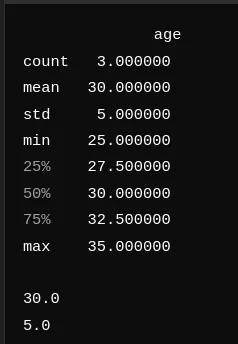
У зведенні середній вік — 30 років зі стандартним відхиленням 5; найменший і найбільший вік — 25 і 35 років. Це дає швидке уявлення про розподіл віку.
Групування та узагальнення
Групування й узагальнення — одна з сильних сторін pandas. Функції groupby і pivot_table значно це спрощують.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)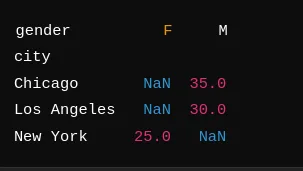
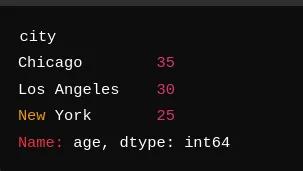
Групування за містом дає середній вік для кожного міста: Chicago (35), Los Angeles (30) і New York (25). Зведена таблиця дає схоже зведення з розбивкою за статтю; у нашому прикладі немає даних про стать, тому в цих клітинках стоїть NaN.
Візуалізація даних у pandas
У pandas є прості, але дієві інструменти для побудови графіків. Функції plot, hist і boxplot швидко будують графіки.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Робота із Seaborn і Matplotlib
Дані pandas можна візуалізувати й за допомогою Seaborn і Matplotlib, які дають змогу будувати детальніші графіки з ширшими можливостями налаштування.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Аналіз часових рядів
Pandas чудово працює з часовими рядами, тож у них легко знаходити тренди й закономірності.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())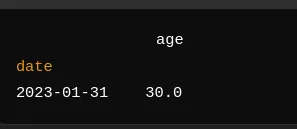
Тут ми перетворюємо стовпець date на datetime і робимо його індексом. Ресемплінг за місяцями із середнім значенням дає середній вік 30 років за січень 2023 року.
Об’єднання та поєднання даних
У pandas багато функцій для об’єднання наборів даних, наприклад merge, join і concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)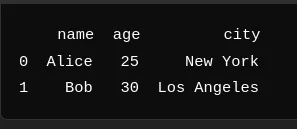
У цьому прикладі ми об’єднуємо два DataFrame за стовпцем name, поєднуючи вік і місто кожної людини.
Практичний приклад: аналіз синтетичних даних
Створення даних
Для практичного прикладу створимо синтетичні дані, які покажуть можливості pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())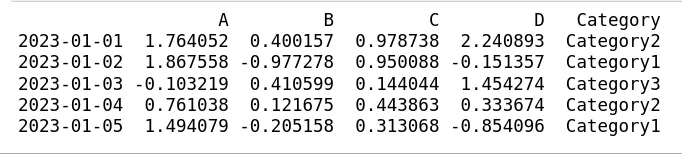
Так створюється DataFrame на 100 рядків зі стовпцями A, B, C і D та категоріальним стовпцем Category. Значення випадкові, а Category набуває одного з трьох значень.
Аналіз і візуалізація
На синтетичних даних проведемо базовий аналіз і побудуємо графіки.
# Statistical summary
print(df.describe())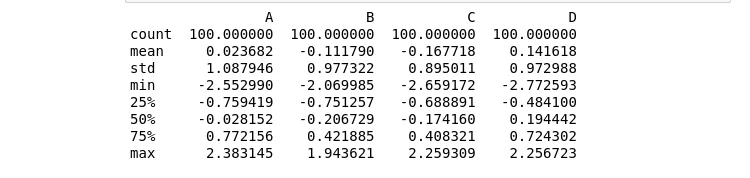
Зведення дає повний огляд даних. Середні значення стовпців A, B, C і D близькі до нуля, як і очікується для випадкового нормального розподілу, а стандартні відхилення близькі до 1 і показують розкид значень навколо середнього.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)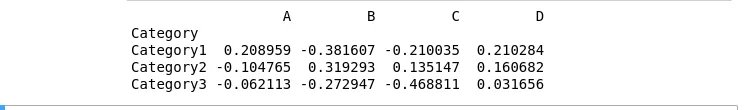
Групування за Category показує середнє значення кожного стовпця для кожної категорії, що виявляє відмінності між категоріями.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()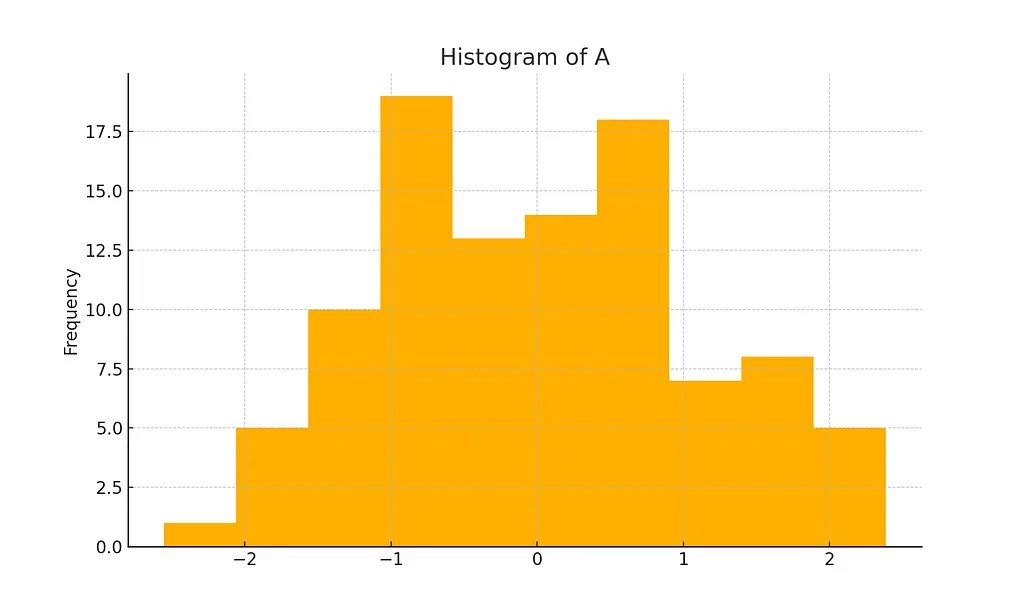
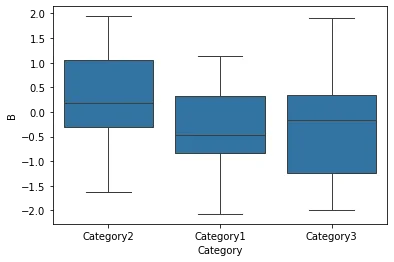
Гістограма показує розподіл значень у стовпці A, а коробкова діаграма — стовпець B за категоріями. Такі графіки допомагають зрозуміти розподіл і помітити викиди чи закономірності.
Висновок
Pandas — універсальний і потужний інструмент аналізу даних; гнучкість і простота роблять його незамінним для фахівців із даних. У цій статті ми розглянули його основні можливості та їхнє місце в аналізі й показали практичне застосування на синтетичних даних. Практикуючись далі й опановуючи складніші прийоми, ви зможете глибше зануритися в науку про дані та з допомогою pandas отримувати зі своїх даних більше корисних висновків.
Джерела
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2-ге вид.). O’Reilly Media.
- Команда розробників pandas. Документація pandas. pandas.pydata.org
- Документація NumPy. numpy.org
- Документація Matplotlib. matplotlib.org
- Документація Seaborn. seaborn.pydata.org