

Analiza datelor cu Pandas: prelucrarea și vizualizarea datelor
Scris de Yasin TANIŞ
Introducere
Analiza datelor a devenit o parte integrantă a procesului decizional. Python se remarcă în acest domeniu datorită bibliotecilor sale puternice de analiză și prelucrare a datelor. Una dintre ele, pandas, este indispensabilă specialiștilor în știința datelor pentru că este flexibilă și ușor de folosit. În acest articol analizăm funcționalitățile de bază ale pandas și modul în care este folosit în analiza datelor, cu exemple practice pe date reale sau sintetice.
DataFrame și Series
Pandas lucrează cu două structuri de date principale. DataFrame este o structură bidimensională de rânduri și coloane. Series este unidimensională și reprezintă o singură coloană de date.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)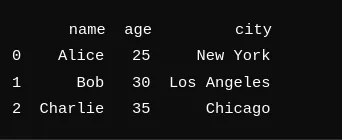
Crearea unui DataFrame
Un DataFrame se poate crea în multe feluri. Puteți încărca date din surse precum CSV, Excel și SQL și le puteți transforma în DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Încărcarea și salvarea datelor
Pandas simplifică încărcarea și salvarea datelor. Puteți citi și prelucra fișiere în multe formate diferite.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Curățarea și pregătirea datelor
Curățarea și pregătirea sunt etape esențiale ale analizei datelor. Pandas ușurează tratarea valorilor lipsă, conversia tipurilor de date și eliminarea datelor inutile.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])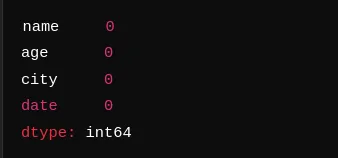
Aici verificăm dacă DataFrame-ul are valori lipsă. Rezultatul arată că nicio coloană nu are valori lipsă.
Sinteze statistice
Pandas oferă multe instrumente pentru a sintetiza rapid datele. Statisticile și sintezele de bază se obțin cu un singur apel.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())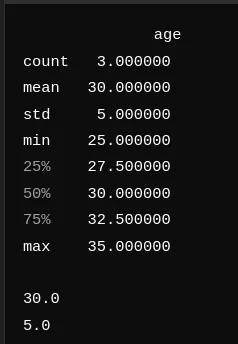
În sinteză, vârsta medie este 30, cu o abatere standard de 5; vârsta minimă și cea maximă sunt 25, respectiv 35. Astfel obținem rapid o imagine a distribuției vârstelor din date.
Gruparea și sinteza
Gruparea și sinteza sunt printre punctele forte ale pandas. Funcțiile groupby și pivot_table le fac simple.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)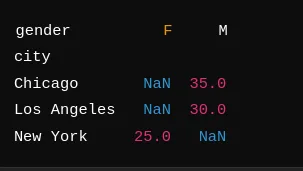
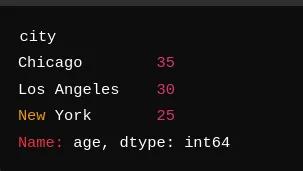
Grupând pe orașe obținem vârsta medie pentru fiecare: Chicago (35), Los Angeles (30) și New York (25). Tabelul pivot oferă o sinteză similară defalcată pe gen; exemplul nostru nu are date despre gen, așa că acele celule arată NaN.
Vizualizarea datelor cu pandas
Pandas are instrumente simple, dar eficiente, pentru grafice. Funcții precum plot, hist și boxplot creează rapid grafice.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Lucrul cu Seaborn și Matplotlib
Datele din pandas pot fi vizualizate și cu Seaborn și Matplotlib, care permit grafice mai personalizate și mai detaliate.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Analiza seriilor de timp
Pandas lucrează foarte bine cu seriile de timp, ceea ce face ușoară identificarea tendințelor și a tiparelor.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())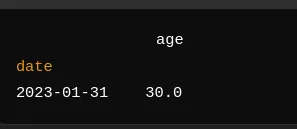
Aici convertim coloana date în datetime și o setăm ca index. Prin reeșantionare lunară și calcularea mediei obținem o vârstă medie de 30 pentru ianuarie 2023.
Îmbinarea și combinarea datelor
Pandas are multe funcții pentru îmbinarea și combinarea seturilor de date, precum merge, join și concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)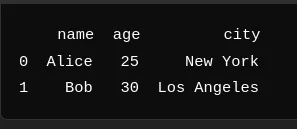
În acest exemplu îmbinăm două DataFrame-uri după coloana name, reunind vârsta și orașul fiecărei persoane.
Exemplu practic: analiză cu date sintetice
Crearea datelor
Pentru un exemplu practic creăm date sintetice care arată ce poate face pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())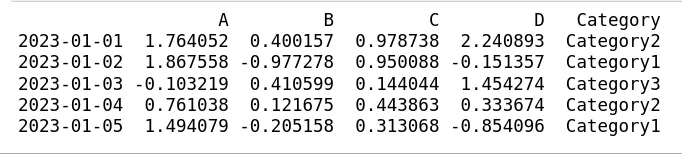
Astfel se creează un DataFrame de 100 de rânduri cu coloanele A, B, C și D și o coloană categorială Category. Valorile sunt aleatoare, iar Category ia una dintre trei valori.
Analiză și vizualizare
Cu datele sintetice facem câteva analize de bază și desenăm grafice.
# Statistical summary
print(df.describe())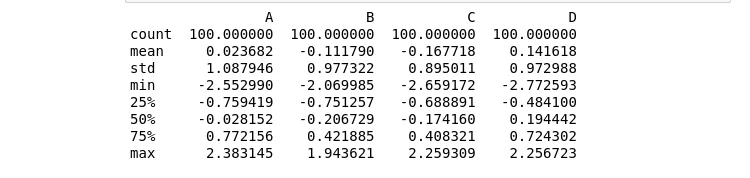
Sinteza oferă o imagine completă a datelor. Mediile coloanelor A, B, C și D sunt aproape de zero, așa cum se așteaptă de la o distribuție normală aleatoare, iar abaterile standard sunt aproape de 1, arătând cât de mult se împrăștie valorile în jurul mediei.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)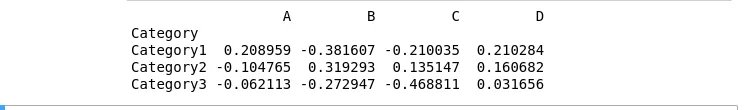
Gruparea după Category arată media fiecărei coloane pentru fiecare categorie și dezvăluie cum diferă categoriile.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()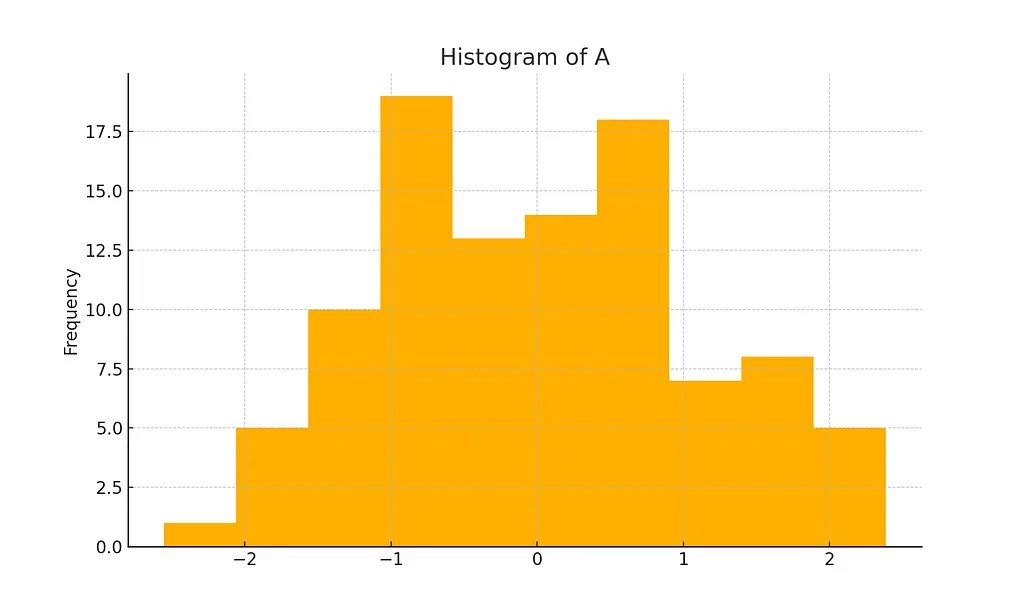
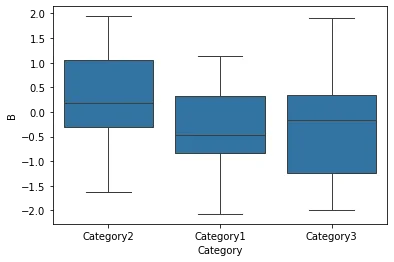
Histograma arată distribuția valorilor din coloana A, iar diagrama box plot arată coloana B pe categorii. Astfel de grafice vă ajută să înțelegeți distribuția și să observați valori aberante sau tipare.
Concluzie
Pandas este un instrument versatil și puternic de analiză a datelor; flexibilitatea și ușurința de folosire îl fac indispensabil pentru specialiștii în știința datelor. În acest articol am prezentat funcționalitățile sale de bază și locul lor într-o analiză și am arătat o utilizare practică pe date sintetice. Cu mai multă practică și tehnici mai avansate puteți aprofunda știința datelor și puteți extrage mai multe informații din datele dumneavoastră cu pandas.
Surse
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (ed. a 2-a). O’Reilly Media.
- Echipa de dezvoltare pandas. Documentația pandas. pandas.pydata.org
- Documentația NumPy. numpy.org
- Documentația Matplotlib. matplotlib.org
- Documentația Seaborn. seaborn.pydata.org