

Was ist ein unausgewogener Datensatz und wie geht man damit um?
Von Yasin TANIŞ
Was ist ein unausgewogener Datensatz?
Sie bauen für ein Unternehmen ein Klassifikationsmodell, und es erreicht 95 % Genauigkeit. Alles sieht gut aus. Das Modell geht in Betrieb, und bald fällt auf, dass es immer dieselbe Klasse vorhersagt. Beim erneuten Blick auf die Daten sehen Sie: Die Klasse, die es nie erkennt, macht nur 5 % der Daten aus. Das Versagen des Modells ist auf einen unausgewogenen Datensatz zurückzuführen.
Unausgewogene Datensätze treten bei Klassifikationsproblemen auf, wenn die Klassen alles andere als gleichmäßig verteilt sind. Das Problem: Die Mehrheitsklasse überdeckt die Minderheitsklasse. Das Modell tendiert zur Mehrheitsklasse und klassifiziert die Minderheitsklasse schlecht.
Bei unausgewogenen Daten helfen diese Methoden, richtig zu beobachten und das Gleichgewicht wiederherzustellen:
- Die richtigen Metriken wählen: Precision, Recall, F1-Score, ROC-Kurve und AUC
- Resampling: Oversampling (zufällig und SMOTE) und Undersampling (zufällig, NearMiss, Tomek-Links, Cluster-Zentroide)
- Mehr Daten sammeln
- Den Parameter
class_weightvon Klassifikationsmodellen nutzen, damit das Modell gleichermaßen aus Minderheits- und Mehrheitsklasse lernt - Die Leistung anderer Modelle betrachten, statt sich auf eines zu verlassen
- Einen anderen Ansatz wählen, etwa Anomalie- oder Änderungserkennung
Zuerst untersuchen wir den unausgewogenen Datensatz Credit Card Fraud Detection, dann wenden wir mehrere Methoden an, um mit dem Ungleichgewicht umzugehen.
Den Datensatz untersuchen
Betrugserkennung ist für Kreditkartenunternehmen wichtig: Kundinnen und Kunden sollen nicht für Käufe zahlen, die sie nicht getätigt haben.
Datensatz: creditcard.csv (Kaggle)
Mit diesem Datensatz wollen wir ein Modell bauen, das betrügerische Transaktionen erkennt. Die Daten stammen aus Kartentransaktionen in Europa im September 2013; jede Transaktion ist mit 1 markiert, wenn es sich um Betrug handelt, sonst mit 0. Aus Datenschutzgründen gibt es nur wenige Hintergrundinformationen, und alle Variablen außer Time und Amount wurden mit PCA (Hauptkomponentenanalyse) transformiert.
Time: Sekunden zwischen der ersten und der jeweiligen TransaktionAmount: Betrag der Transaktion
Zuerst lesen wir die Daten ein, prüfen auf fehlende Werte und sehen uns die Verteilung der Variable Class an. Dann standardisieren wir Amount und Time, teilen die Daten nach dem Hold-out-Verfahren auf und bauen ein Klassifikationsmodell mit logistischer Regression. Wir arbeiten mit einem einzigen Modell.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()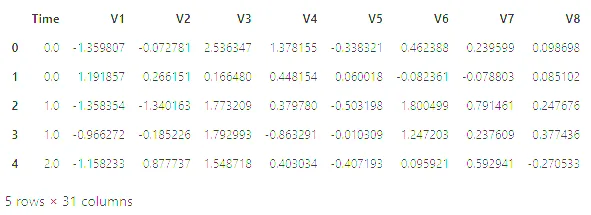
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Der Code gibt die Beschriftungen auf Türkisch aus: Anzahl der Beobachtungen und Anzahl der Variablen.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()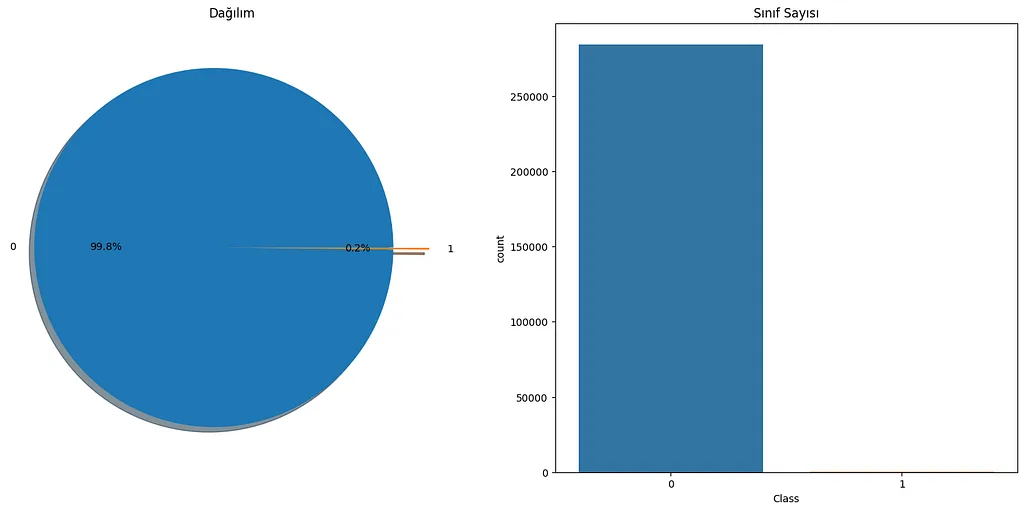
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()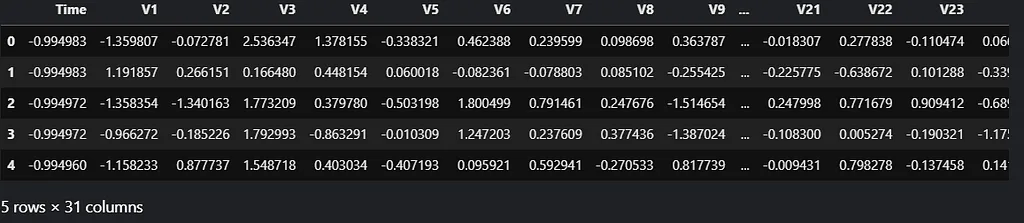
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Genauigkeit (Accuracy) ist der Anteil korrekter Vorhersagen an allen Vorhersagen. Unser Modell erreicht 0,999. Man könnte also sagen, dass es perfekt funktioniert, oder? Sehen wir uns auch die Konfusionsmatrix an.
Die Konfusionsmatrix
Eine Konfusionsmatrix ist eine Tabelle, die zusammenfasst, wie ein Klassifikationsmodell auf Testdaten abschneidet. Sie enthält die vier Kombinationen aus vorhergesagten und tatsächlichen Werten. Hier gilt Betrug als positive Klasse:
- Richtig positiv (TP): positiv vorhergesagt und richtig.
- Richtig negativ (TN): negativ vorhergesagt und richtig.
- Falsch positiv (FP): positiv vorhergesagt, aber falsch.
- Falsch negativ (FN): negativ vorhergesagt, aber falsch.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')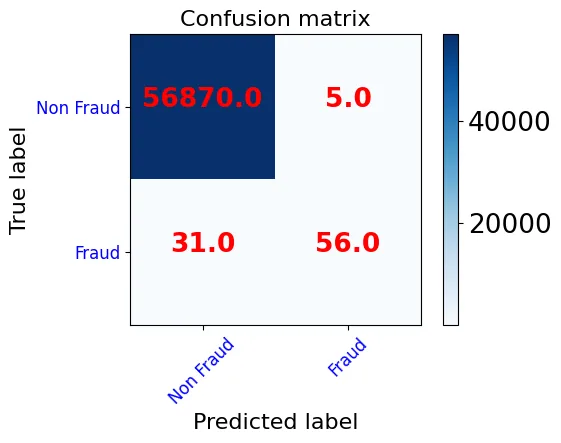
- Von den 56875 tatsächlich normalen Transaktionen werden 56870 richtig vorhergesagt und 5 fälschlich als Betrug markiert (FP).
- Von den 87 tatsächlichen Betrugsfällen werden 56 erkannt (TP) und 31 übersehen (FN).
Das Modell weist eine Genauigkeit von 0,999 aus, doch die Konfusionsmatrix zeigt eine hohe Fehlerquote in der Betrugsklasse. Das Modell sagt die Mehrheitsklasse gut und die Minderheitsklasse schlecht vorher. Weil es so viel mehr normale als betrügerische Transaktionen gibt, wirkt das Modell erfolgreich, nur weil es die normale Klasse vorhersagt.
Die Lehre: Genauigkeit ist kein gutes Leistungsmaß für Klassifikationsmodelle, besonders bei so unausgewogenen Daten wie unseren. Sehen wir uns an, wie man mit dem Ungleichgewicht umgeht, welche Methoden man anwendet und mit welchen Metriken man die Leistung misst.
Die richtigen Metriken wählen
Wir haben gesehen, dass die Genauigkeit nicht ausreicht; um die Leistung zu messen, brauchen wir weitere Metriken.
Precision: der Anteil der positiv vorhergesagten Fälle, die tatsächlich positiv sind. Niedrige Precision bedeutet viele falsch positive Fälle. Precision = TP / (TP + FP).
Recall: der Anteil der tatsächlich positiven Fälle, die wir als positiv vorhergesagt haben. Niedriger Recall bedeutet viele falsch negative Fälle; er sollte möglichst hoch sein. Recall = TP / (TP + FN).
F1-Score: Ein Modell mit niedriger Precision und hohem Recall lässt sich nur schwer mit einem Modell vergleichen, bei dem es umgekehrt ist. Der F1-Score misst beides zusammen als harmonisches Mittel aus Precision und Recall. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Sehen wir uns diese Metriken für unser Modell an. Der Klassifikationsbericht zeigt die wichtigsten Metriken je Klasse.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))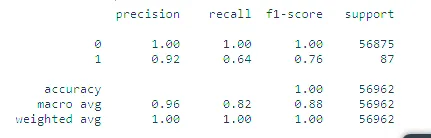
Precision je Klasse:
- Klasse 0 (normal): 56870 + 31 = 56901 Transaktionen als normal vorhergesagt, 56870 davon richtig. Precision ≈ 1,00 (56870 / 56901).
- Klasse 1 (Betrug): 5 + 56 = 61 Transaktionen als Betrug vorhergesagt, 56 davon richtig. Precision ≈ 0,92 (56 / 61).
Recall je Klasse:
- Klasse 0 (normal): Von 56870 + 5 = 56875 normalen Transaktionen werden 56870 richtig vorhergesagt. Recall ≈ 1,00.
- Klasse 1 (Betrug): Von 31 + 56 = 87 betrügerischen Transaktionen werden 56 richtig vorhergesagt. Recall = 56 / 87 ≈ 0,64.
Die Recall-Werte machen das Versagen bei Klasse 1 deutlich. Der F1-Score ist das harmonische Mittel aus Recall und Precision. Support ist die tatsächliche Anzahl der Beispiele je Klasse; der Unterschied zwischen den Klassen zeigt eine strukturelle Schwäche der Messungen, da das Ungleichgewicht selbst sie beeinflusst.
Die ROC-Kurve
Die ROC-Kurve ist ein Diagramm, das die Leistung eines Klassifikationsmodells über alle Entscheidungsschwellen hinweg darstellt. Sie zeigt zwei Größen:
- Richtig-positiv-Rate (TPR), also der Recall: TPR = TP / (TP + FN)
- Falsch-positiv-Rate (FPR), also der Anteil der Fehlalarme bei normalen Transaktionen: FPR = FP / (FP + TN)
Die Kurve trägt TPR gegen FPR bei verschiedenen Schwellen auf; sie beginnt bei (0,0) und endet bei (1,1). Ein gutes Modell erzeugt eine Kurve, die schnell von 0 auf 1 steigt.
AUC (Fläche unter der ROC-Kurve)
AUC fasst die ROC-Kurve in einer Zahl zusammen: Sie misst die gesamte Fläche unter der Kurve von (0,0) bis (1,1). Der beste Wert ist 1; zufälliges Raten ergibt 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)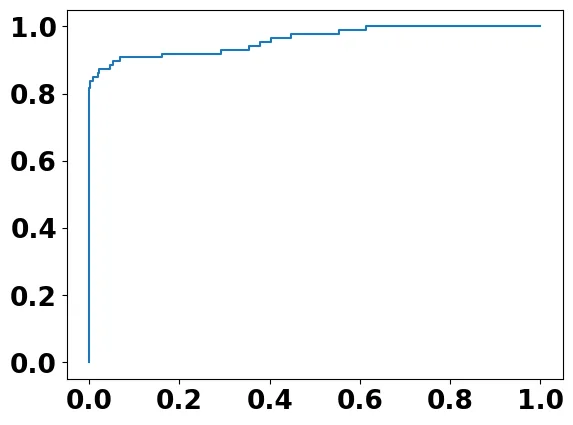
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Hinweis: AUC bewertet die gesamte Klassifikationsleistung. Da sie keine Klasse stärker gewichtet als die andere, spiegelt sie die Leistung bei der Minderheitsklasse schlecht wider.
Wenden wir nun einige Methoden auf den Datensatz an, um das Ungleichgewicht zu beseitigen.
Wichtig: Diese Methoden dürfen nur auf die Trainingsdaten angewandt werden. Werden sie auf die Testdaten angewandt, ist keine korrekte Bewertung mehr möglich.
Resampling
Resampling macht einen Datensatz ausgewogener, indem es der Minderheitsklasse neue Beispiele hinzufügt oder der Mehrheitsklasse Beispiele entnimmt. Undersampling entfernt Mehrheitsbeispiele; Oversampling vervielfacht Minderheitsbeispiele.
Oversampling
Oversampling gleicht die Daten aus, indem es Beispiele der Minderheitsklasse dupliziert.
Zufälliges Oversampling:
- Zufällig gewählte Beispiele der Minderheitsklasse werden hinzugefügt, um den Datensatz auszugleichen.
- Geeignet, wenn der Datensatz klein ist.
- Kann zu Überanpassung (Overfitting) führen.
RandomOverSampler akzeptiert das Argument sampling_strategy. Mit sampling_strategy='minority' wird die Minderheitsklasse vervielfacht, bis sie so groß ist wie die Mehrheitsklasse. Auch eine Dezimalzahl ist möglich: Hat die Mehrheitsklasse 1000 und die Minderheitsklasse 100 Beispiele, erhöht sampling_strategy=0.5 die Minderheitsklasse auf 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')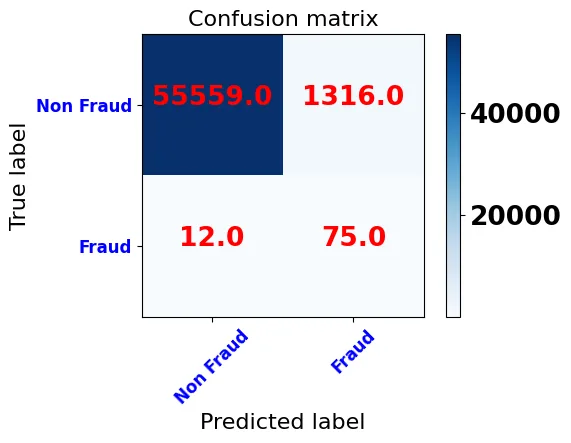
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Nach zufälligem Oversampling sinkt die Genauigkeit des Modells auf 0,977. Konfusionsmatrix und Klassifikationsbericht zeigen, dass die meisten als Betrug markierten Transaktionen Fehlalarme sind; das senkt die Precision der Klasse 1 auf 0,05. Im Gegenzug steigt der Recall der Klasse 1 auf 0,86: 75 der 87 Betrugsfälle werden erkannt. Normale Transaktionen werden etwas schlechter vorhergesagt als beim ersten Modell, doch dieser Sprung bei der Betrugserkennung ist ein starkes Argument für das nach zufälligem Oversampling trainierte Modell.
SMOTE-Oversampling:
Um Überanpassung zu vermeiden, werden statt Kopien synthetische Minderheitsbeispiele erzeugt:
- Aus der Minderheitsklasse wird zufällig ein Beispiel ausgewählt.
- Seine k nächsten Nachbarn werden bestimmt.
- Ein Nachbar wird zufällig gewählt; im Merkmalsraum wird eine Strecke zwischen Beispiel und Nachbar gezogen, und auf dieser Strecke entsteht das synthetische Beispiel.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975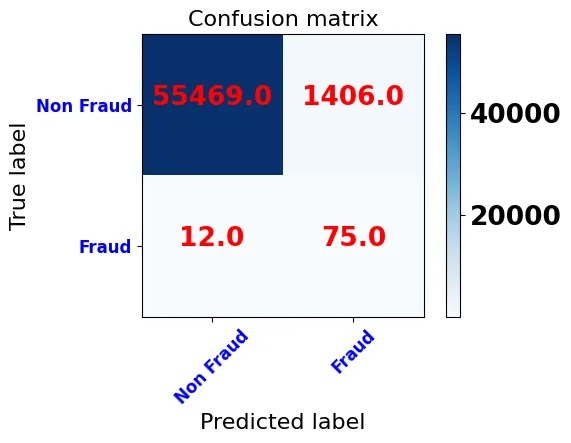
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Die Ergebnisse nach SMOTE ähneln dem zufälligen Oversampling: Wieder werden 75 der 87 Betrugsfälle erkannt, während die Fehlalarme auf 1406 steigen.
Undersampling
Undersampling gleicht die Daten aus, indem es Beispiele der Mehrheitsklasse entfernt, und eignet sich für große Datensätze. Unser Datensatz ist dafür nicht groß genug, aber wir erklären die Methoden und zeigen, wie einige davon angewandt werden.
Zufälliges Undersampling:
- Die zu entfernenden Beispiele werden zufällig gewählt.
- Geeignet, wenn Sie einen großen Datensatz haben.
- Die zufällige Auswahl kann zu Informationsverlust führen.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss-Undersampling:
- Verringert den Informationsverlust.
- Beruht auf dem KNN-Algorithmus.
- Berechnet den Abstand der Mehrheitsbeispiele zu den Minderheitsbeispielen.
- Behält die Mehrheitsbeispiele, die der Minderheitsklasse am nächsten liegen, gemäß einem vorgegebenen k.
Tomek-Links: Für jedes Paar nächstgelegener Beispiele aus verschiedenen Klassen wird das Mehrheitsbeispiel entfernt, wodurch der Abstand zwischen den Klassen wächst.
Cluster-Zentroide: Unwichtige Beispiele werden aus dem Datensatz entfernt; ob ein Beispiel wichtig ist, entscheidet ein Clustering.
Undersampling und Oversampling lassen sich kombinieren, um ausgewogenere Datensätze zu erhalten.
Weitere Methoden
- Mehr Daten sammeln
- Den Parameter
class_weightnutzen, damit das Modell gleichermaßen aus Minderheits- und Mehrheitsklasse lernt - Die Leistung anderer Modelle betrachten, nicht nur die eines einzigen
- Einen anderen Ansatz wählen, etwa Anomalie- oder Änderungserkennung
Welche Methode am besten funktioniert, hängt vom jeweiligen Datensatz ab. Das beste Ergebnis erzielt man, wenn man die Methoden ausprobiert und diejenige wählt, die zu den eigenen Daten passt.
Quellen
- Kaggle: Über unausgewogene Datensätze (Yasin Tanış, auf Türkisch)
- Miuul: Was ist ein unausgewogener Datensatz (auf Türkisch)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes