

Çfarë është një grup i pabalancuar të dhënash dhe si trajtohet?
Shkruar nga Yasin TANIŞ
Çfarë është një grup i pabalancuar të dhënash
Ndërtoni një model klasifikimi për një biznes dhe ai arrin saktësi 95 %. Gjithçka duket në rregull. Modeli vihet në përdorim, por shpejt dikush vëren se ai parashikon gjithmonë të njëjtën klasë. Kur i rishikoni të dhënat, shihni se klasa që modeli nuk e zbulon kurrë përbën vetëm 5 % të të dhënave. Dështimi i modelit vjen nga grupi i pabalancuar i të dhënave.
Grupet e pabalancuara të të dhënave shfaqen në problemet e klasifikimit kur klasat janë larg një shpërndarjeje të barabartë. Problemi është se klasa e shumicës e lë në hije klasën e pakicës: modeli anon drejt shumicës dhe e klasifikon keq pakicën.
Kur përballemi me të dhëna të pabalancuara, këto janë metodat që mund të përdorim për të vëzhguar saktë dhe për të rikthyer balancën:
- Zgjedhja e metrikave të duhura: precision, recall, rezultati F1, kurba ROC dhe AUC
- Rimostrimi: oversampling (i rastësishëm dhe SMOTE) dhe undersampling (i rastësishëm, NearMiss, lidhjet Tomek, qendrat e grupimeve)
- Mbledhja e më shumë të dhënave
- Përdorimi i parametrit
class_weighttë modeleve të klasifikimit, që modeli të mësojë njëlloj nga klasa e pakicës dhe nga ajo e shumicës - Shqyrtimi i performancës së modeleve të tjera, në vend që të mbështetemi vetëm te një
- Ndjekja e një qasjeje tjetër, si zbulimi i anomalive ose i ndryshimeve
Fillimisht shqyrtojmë grupin e të dhënave Credit Card Fraud Detection, i cili është i pabalancuar, dhe pastaj zbatojmë disa metoda për ta trajtuar këtë pabalancë.
Shqyrtimi i grupit të të dhënave
Zbulimi i mashtrimeve është i rëndësishëm për kompanitë e kartave të kreditit: ato nuk duan që klientëve t’u ngarkohen blerje që nuk i kanë bërë.
Grupi i të dhënave: creditcard.csv (Kaggle)
Me këtë grup të dhënash duam të ndërtojmë një model që zbulon transaksionet mashtruese. Të dhënat vijnë nga transaksione me karta të kryera në Evropë në shtator 2013; çdo transaksion shënohet me 1 nëse është mashtrim dhe me 0 nëse nuk është. Për arsye privatësie ka pak informacion kontekstual, dhe të gjitha ndryshoret përveç Time dhe Amount janë transformuar me PCA (analiza e komponentëve kryesorë).
Time: sekondat e kaluara nga transaksioni i parë deri te secili transaksionAmount: shuma e transaksionit
Fillimisht lexojmë të dhënat, kontrollojmë për vlera që mungojnë dhe shohim shpërndarjen e ndryshores Class. Pastaj standardizojmë Amount dhe Time, i ndajmë të dhënat me metodën hold-out dhe ndërtojmë një model klasifikimi me regresion logjistik. Do të punojmë me një model të vetëm.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()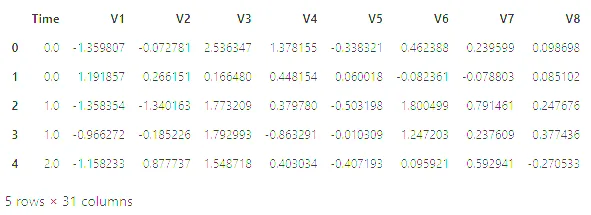
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Kodi i shfaq etiketat në turqisht: numri i vëzhgimeve dhe numri i ndryshoreve.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()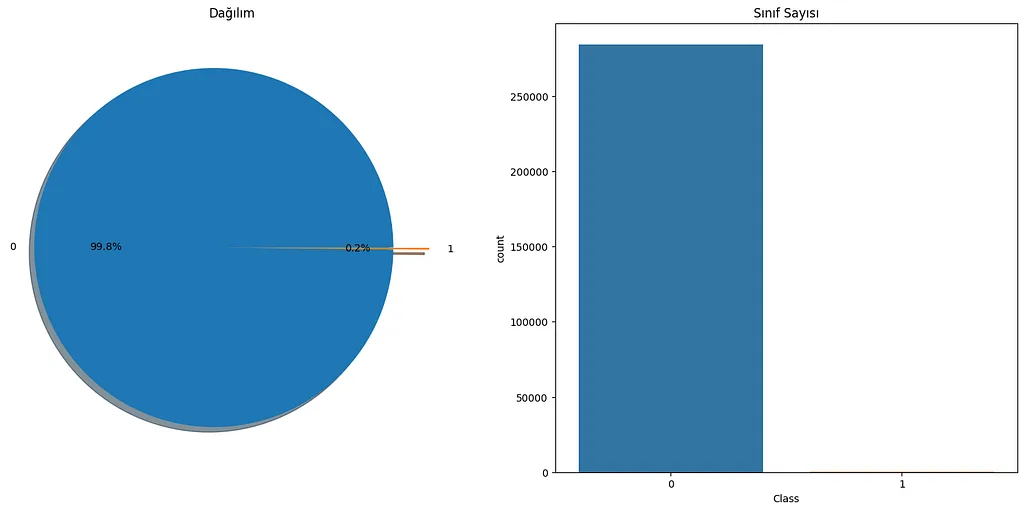
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()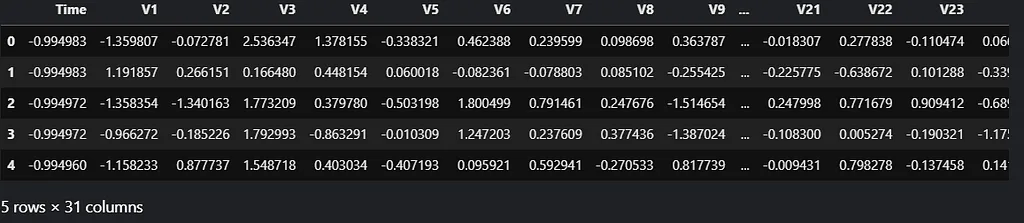
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Saktësia është raporti i parashikimeve të sakta ndaj të gjitha parashikimeve. Modeli ynë arrin 0,999. Mund të themi se funksionon në mënyrë të përsosur, apo jo? Le të shohim edhe matricën e konfuzionit.
Matrica e konfuzionit
Matrica e konfuzionit është një tabelë që përmbledh performancën e një modeli klasifikimi në të dhënat e testit. Ajo përmban katër kombinimet e vlerave të parashikuara dhe atyre reale. Këtu mashtrimin e trajtojmë si klasë pozitive:
- Pozitiv i vërtetë (TP): parashikohet pozitiv dhe parashikimi është i saktë.
- Negativ i vërtetë (TN): parashikohet negativ dhe parashikimi është i saktë.
- Pozitiv i rremë (FP): parashikohet pozitiv, por parashikimi është i gabuar.
- Negativ i rremë (FN): parashikohet negativ, por parashikimi është i gabuar.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')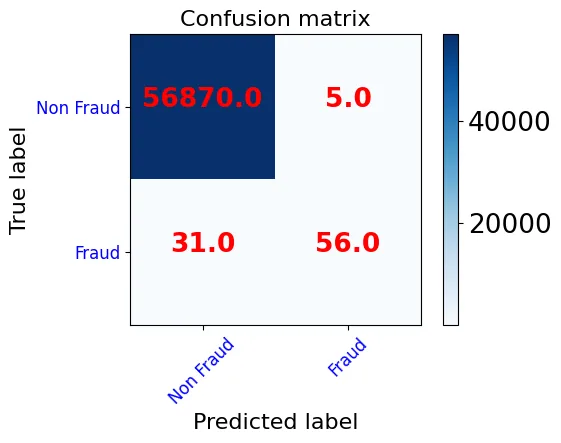
- Nga 56875 transaksionet që janë realisht normale, 56870 parashikohen saktë dhe 5 shënohen gabimisht si mashtrim (FP).
- Nga 87 transaksionet që janë realisht mashtruese, 56 kapen (TP) dhe 31 nuk kapen (FN).
Modeli pretendon saktësi 0,999, por matrica e konfuzionit tregon një shkallë të lartë gabimi në klasën e mashtrimeve. Modeli e parashikon mirë klasën e shumicës dhe keq atë të pakicës. Meqë transaksionet normale janë shumë më të shumta se ato mashtruese, modeli duket i suksesshëm duke parashikuar klasën normale.
Mësimi: saktësia nuk është masë e mirë e performancës për modelet e klasifikimit, sidomos kur të dhënat janë aq të pabalancuara sa tonat. Le të shohim si trajtohet pabalanca, cilat metoda të zbatojmë dhe me cilat metrika ta masim performancën.
Zgjedhja e metrikave të duhura
Pamë se saktësia nuk mjafton; për të matur performancën na duhen metrika të tjera.
Precision (precizioni): pjesa e pozitivëve të parashikuar që janë realisht pozitivë. Precizion i ulët do të thotë shumë pozitivë të rremë. Precision = TP / (TP + FP).
Recall (rikujtimi): pjesa e pozitivëve realë që i parashikuam pozitivë. Rikujtim i ulët do të thotë shumë negativë të rremë; duhet të jetë sa më i lartë. Recall = TP / (TP + FN).
Rezultati F1: është e vështirë të krahasosh një model me precizion të ulët dhe rikujtim të lartë me një model që ka të kundërtën. Rezultati F1 i mat të dyja së bashku, si mesatare harmonike e precizionit dhe rikujtimit. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Le t’i shohim këto metrika për modelin tonë. Raporti i klasifikimit tregon metrikat kryesore sipas klasave.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))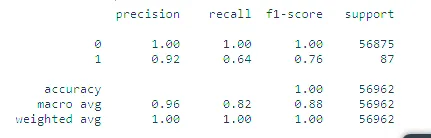
Precizioni sipas klasave:
- Klasa 0 (normale): 56870 + 31 = 56901 transaksione u parashikuan normale, nga të cilat 56870 saktë. Precision ≈ 1,00 (56870 / 56901).
- Klasa 1 (mashtrim): 5 + 56 = 61 transaksione u parashikuan mashtrim, nga të cilat 56 saktë. Precision ≈ 0,92 (56 / 61).
Rikujtimi sipas klasave:
- Klasa 0 (normale): nga 56870 + 5 = 56875 transaksione normale, 56870 parashikohen saktë. Recall ≈ 1,00.
- Klasa 1 (mashtrim): nga 31 + 56 = 87 transaksione mashtruese, 56 parashikohen saktë. Recall = 56 / 87 ≈ 0,64.
Vlerat e rikujtimit e bëjnë të qartë dështimin te klasa 1. Rezultati F1 është mesatarja harmonike e rikujtimit dhe precizionit. Support është numri real i shembujve në secilën klasë; diferenca mes klasave tregon një dobësi strukturore të matjeve, sepse vetë pabalanca ndikon mbi to.
Kurba ROC
Kurba ROC është një grafik i performancës së një modeli klasifikimi në të gjitha pragjet e vendimit. Ajo paraqet dy vlera:
- Shkalla e pozitivëve të vërtetë (TPR), pra rikujtimi: TPR = TP / (TP + FN)
- Shkalla e pozitivëve të rremë (FPR), pra shkalla e alarmeve të rreme te transaksionet normale: FPR = FP / (FP + TN)
Kurba paraqet TPR kundrejt FPR në pragje të ndryshme; nis në (0,0) dhe mbaron në (1,1). Një model i mirë jep një kurbë që ngjitet shpejt nga 0 në 1.
AUC (sipërfaqja nën kurbën ROC)
AUC e përmbledh kurbën ROC në një numër të vetëm: mat të gjithë sipërfaqen nën kurbë nga (0,0) në (1,1). Vlera më e mirë është 1; hamendësimi i rastësishëm jep 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)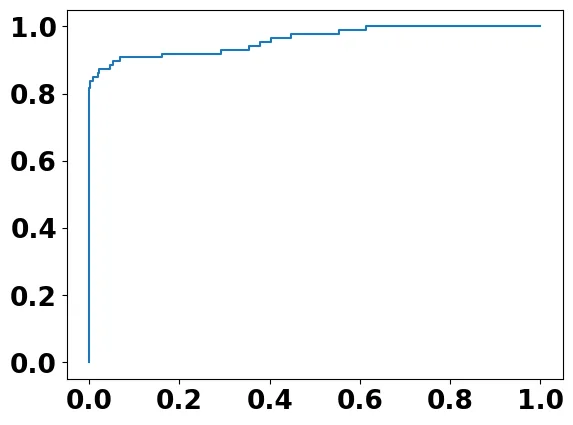
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Shënim: AUC vlerëson performancën e përgjithshme të klasifikimit. Meqë nuk i jep njërës klasë më shumë peshë se tjetrës, nuk e pasqyron mirë performancën te klasa e pakicës.
Tani le të zbatojmë disa metoda në grupin e të dhënave për ta eliminuar pabalancën.
E rëndësishme: këto metoda duhet të zbatohen vetëm në grupin e trajnimit. Nëse zbatohen në grupin e testit, një vlerësim i saktë bëhet i pamundur.
Rimostrimi
Rimostrimi (resampling) e bën një grup të dhënash më të balancuar duke i shtuar shembuj të rinj klasës së pakicës ose duke hequr shembuj nga klasa e shumicës. Undersampling heq shembuj të shumicës; oversampling shumëfishon shembujt e pakicës.
Oversampling
Oversampling i balancon të dhënat duke kopjuar shembuj të klasës së pakicës.
Oversampling i rastësishëm:
- Shtohen shembuj të zgjedhur rastësisht nga klasa e pakicës për të balancuar grupin e të dhënave.
- Mund të përdoret kur grupi i të dhënave është i vogël.
- Mund të shkaktojë mbipërshtatje (overfitting).
RandomOverSampler merr argumentin sampling_strategy. Me sampling_strategy='minority' klasa e pakicës shumëfishohet derisa të barazohet me klasën e shumicës. Argumenti pranon edhe një numër dhjetor: nëse klasa e shumicës ka 1000 shembuj dhe ajo e pakicës 100, sampling_strategy=0.5 e ngre pakicën në 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')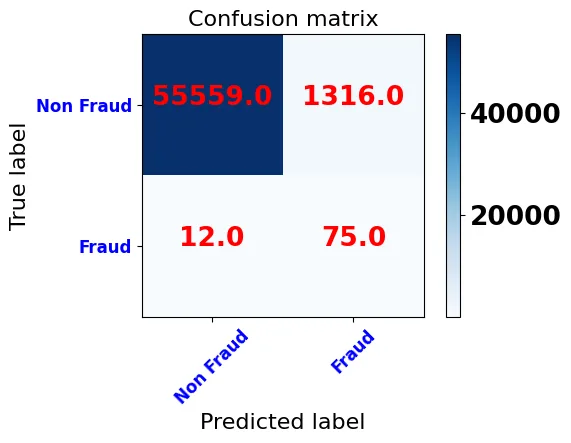
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Pas oversampling-ut të rastësishëm, saktësia e modelit bie në 0,977. Matrica e konfuzionit dhe raporti i klasifikimit tregojnë se shumica e transaksioneve të shënuara si mashtrim janë alarme të rreme, gjë që e ul precizionin e klasës 1 në 0,05. Në këmbim, rikujtimi i klasës 1 ngrihet në 0,86: kapen 75 nga 87 mashtrimet. Transaksionet normale parashikohen pak më keq se me modelin e parë, por ky kërcim në kapjen e mashtrimeve është një arsye e fortë për të preferuar modelin e trajnuar pas oversampling-ut të rastësishëm.
SMOTE oversampling:
Për të shmangur mbipërshtatjen, në vend të kopjeve krijohen shembuj sintetikë të klasës së pakicës:
- Zgjidhet rastësisht një shembull nga klasa e pakicës.
- Gjenden k fqinjët e tij më të afërt.
- Zgjidhet rastësisht një fqinj; në hapësirën e veçorive hiqet një segment mes shembullit dhe fqinjit, dhe shembulli sintetik krijohet mbi këtë segment.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975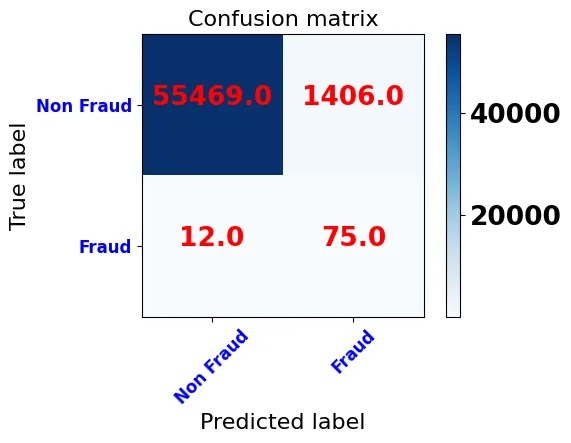
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Rezultatet pas SMOTE janë të ngjashme me ato të oversampling-ut të rastësishëm: sërish kapen 75 nga 87 mashtrimet, ndërsa alarmet e rreme rriten në 1406.
Undersampling
Undersampling i balancon të dhënat duke hequr shembuj nga klasa e shumicës dhe u përshtatet grupeve të mëdha të të dhënave. Grupi ynë nuk është aq i madh sa kjo qasje të funksionojë mirë, por i shpjegojmë metodat dhe tregojmë si zbatohen disa prej tyre.
Undersampling i rastësishëm:
- Shembujt që hiqen zgjidhen rastësisht.
- Mund të përdoret nëse keni një grup të madh të dhënash.
- Zgjedhja e rastësishme mund të sjellë humbje informacioni.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss undersampling:
- Pakëson humbjen e informacionit.
- Bazohet në algoritmin KNN.
- Llogarit largësinë nga shembujt e shumicës te shembujt e pakicës.
- Ruan shembujt e shumicës që janë më afër klasës së pakicës, sipas një vlere të dhënë të k-së.
Lidhjet Tomek: për çdo çift shembujsh më të afërt nga klasa të ndryshme hiqet shembulli i shumicës, gjë që e zgjeron hapësirën mes dy klasave.
Qendrat e grupimeve: shembujt e parëndësishëm hiqen nga grupi i të dhënave; nëse një shembull ka rëndësi, përcaktohet me anë të grupimit (clustering).
Undersampling dhe oversampling mund të kombinohen për të ndërtuar grupe të dhënash më të balancuara.
Metoda të tjera
- Mbledhja e më shumë të dhënave
- Përdorimi i parametrit
class_weight, që modeli të mësojë njëlloj nga klasa e pakicës dhe nga ajo e shumicës - Shqyrtimi i performancës së modeleve të tjera, jo vetëm të njërit
- Ndjekja e një qasjeje tjetër, si zbulimi i anomalive ose i ndryshimeve
Cila metodë funksionon më mirë varet nga grupi i të dhënave në fjalë. Rezultati më i mirë arrihet duke i provuar metodat dhe duke zgjedhur atë që u përshtatet të dhënave tuaja.
Burimet
- Kaggle: Mbi grupet e pabalancuara të të dhënave (Yasin Tanış, në turqisht)
- Miuul: Çfarë është një grup i pabalancuar të dhënash (në turqisht)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes