

Что такое несбалансированный набор данных и что с ним делать?
Автор: Yasin TANIŞ
Что такое несбалансированный набор данных
Вы строите для бизнеса модель классификации, и она даёт точность 95 %. Всё выглядит хорошо. Модель запускают, и вскоре кто-то замечает, что она всегда предсказывает один и тот же класс. Взглянув на данные ещё раз, вы видите: класс, который она никогда не распознаёт, составляет лишь 5 % данных. Провал модели вызван несбалансированным набором данных.
Несбалансированные наборы возникают в задачах классификации, когда классы распределены далеко не поровну. Проблема в том, что мажоритарный класс заглушает миноритарный: модель склоняется к большинству и плохо классифицирует меньшинство.
Когда данные несбалансированы, правильно оценить ситуацию и восстановить баланс помогают такие методы:
- Выбор правильных метрик: precision, recall, F1-мера, ROC-кривая и AUC
- Повторная выборка: оверсэмплинг (случайный и SMOTE) и андерсэмплинг (случайный, NearMiss, связи Томека, центроиды кластеров)
- Сбор дополнительных данных
- Параметр
class_weightмоделей классификации, чтобы модель одинаково училась на меньшинстве и большинстве - Сравнение с другими моделями вместо опоры на одну
- Другой подход, например обнаружение аномалий или изменений
Сначала мы изучим несбалансированный набор Credit Card Fraud Detection, а затем применим несколько методов, чтобы справиться с дисбалансом.
Изучение набора данных
Выявлять мошенничество важно для эмитентов кредитных карт: они не хотят списывать с клиентов деньги за покупки, которых те не совершали.
Набор данных: creditcard.csv (Kaggle)
На этом наборе мы хотим построить модель, которая выявляет мошеннические транзакции. Данные взяты из транзакций по картам в Европе в сентябре 2013 года; каждая транзакция помечена 1, если это мошенничество, и 0, если нет. Из соображений конфиденциальности контекстной информации мало, а все переменные, кроме Time и Amount, преобразованы методом PCA (метод главных компонент).
Time: секунды от первой транзакции до каждой транзакцииAmount: сумма транзакции
Сначала мы читаем данные, проверяем пропуски и смотрим распределение переменной Class. Затем стандартизируем Amount и Time, делим данные методом hold-out и строим модель классификации на логистической регрессии. Будем работать с одной моделью.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()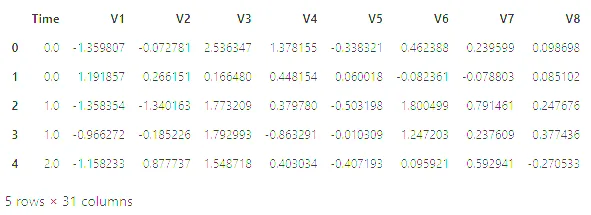
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Код печатает подписи на турецком: число наблюдений и число переменных.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()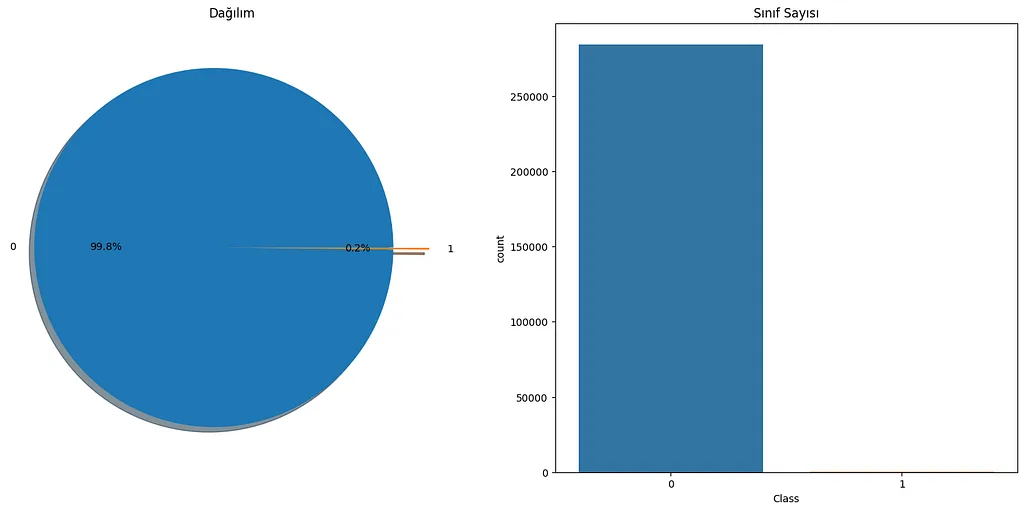
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()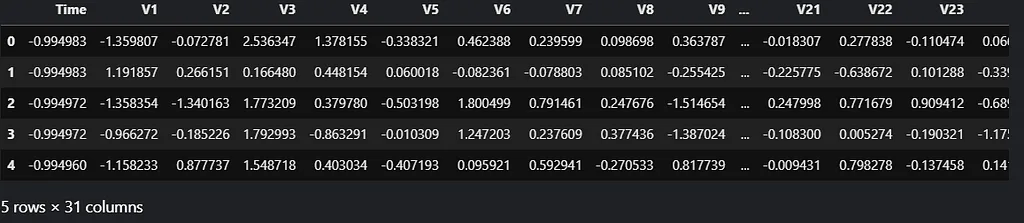
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Доля верных ответов (accuracy) — это отношение правильных предсказаний ко всем предсказаниям. Наша модель даёт 0,999. Можно сказать, что она работает идеально, не так ли? Посмотрим и на матрицу ошибок.
Матрица ошибок
Матрица ошибок (confusion matrix) — таблица, которая показывает, как модель классификации работает на тестовых данных. В ней четыре сочетания предсказанных и истинных значений. Здесь мошенничество считается положительным классом:
- Истинно положительный (TP): предсказан положительный, и верно.
- Истинно отрицательный (TN): предсказан отрицательный, и верно.
- Ложноположительный (FP): предсказан положительный, но ошибочно.
- Ложноотрицательный (FN): предсказан отрицательный, но ошибочно.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')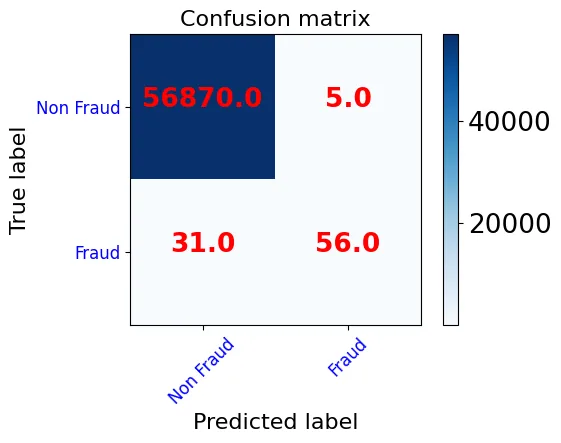
- Из 56875 действительно обычных транзакций 56870 предсказаны верно, а 5 ошибочно помечены как мошенничество (FP).
- Из 87 настоящих случаев мошенничества 56 выявлены (TP), а 31 пропущен (FN).
Модель показывает долю верных ответов 0,999, но матрица ошибок показывает высокую долю ошибок в классе мошенничества. Модель хорошо предсказывает мажоритарный класс и плохо — миноритарный. Поскольку обычных транзакций намного больше, модель выглядит успешной просто потому, что предсказывает обычный класс.
Вывод: доля верных ответов — плохая мера качества для моделей классификации, особенно на таких несбалансированных данных, как наши. Посмотрим, как справиться с дисбалансом, какие методы применить и какими метриками мерить качество.
Выбор правильных метрик
Мы увидели, что доли верных ответов мало; нужны другие метрики.
Precision (точность): доля предсказанных положительных, которые действительно положительны. Низкая точность означает много ложных срабатываний. Precision = TP / (TP + FP).
Recall (полнота): доля действительно положительных, которые мы предсказали как положительные. Низкая полнота означает много пропусков; она должна быть как можно выше. Recall = TP / (TP + FN).
F1-мера: модель с низкой точностью и высокой полнотой трудно сравнить с моделью, у которой всё наоборот. F1-мера учитывает обе величины сразу как гармоническое среднее точности и полноты. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Посмотрим на эти метрики для нашей модели. Отчёт о классификации показывает основные метрики по классам.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))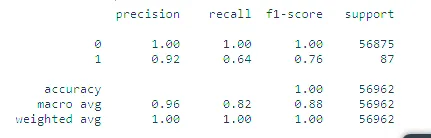
Точность по классам:
- Класс 0 (обычные): 56870 + 31 = 56901 транзакция предсказана как обычная, из них 56870 верно. Precision ≈ 1,00 (56870 / 56901).
- Класс 1 (мошенничество): 5 + 56 = 61 транзакция предсказана как мошенничество, из них 56 верно. Precision ≈ 0,92 (56 / 61).
Полнота по классам:
- Класс 0 (обычные): из 56870 + 5 = 56875 обычных транзакций 56870 предсказаны верно. Recall ≈ 1,00.
- Класс 1 (мошенничество): из 31 + 56 = 87 мошеннических транзакций 56 предсказаны верно. Recall = 56 / 87 ≈ 0,64.
Значения полноты ясно показывают провал на классе 1. F1-мера — гармоническое среднее полноты и точности. Support — истинное число примеров в каждом классе; разрыв между классами указывает на структурную слабость этих оценок: на них влияет сам дисбаланс.
ROC-кривая
ROC-кривая — это график качества модели классификации при всех порогах решения. На нём откладываются две величины:
- Доля истинно положительных (TPR), то есть полнота: TPR = TP / (TP + FN)
- Доля ложноположительных (FPR), то есть ложных тревог на обычных транзакциях: FPR = FP / (FP + TN)
Кривая показывает зависимость TPR от FPR при разных порогах; она начинается в точке (0,0) и заканчивается в точке (1,1). У хорошей модели кривая быстро поднимается от 0 к 1.
AUC (площадь под ROC-кривой)
AUC сводит ROC-кривую к одному числу: измеряет всю площадь под кривой от (0,0) до (1,1). Лучшее значение — 1; случайное угадывание даёт 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)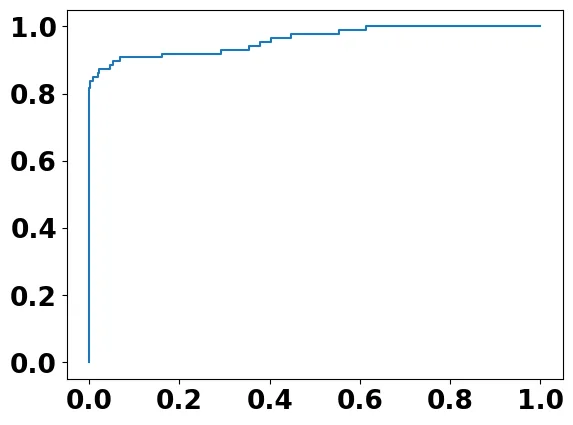
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Примечание: AUC оценивает общее качество классификации. Поскольку она не придаёт больший вес ни одному классу, она плохо отражает качество на миноритарном классе.
Теперь применим несколько методов, чтобы устранить дисбаланс.
Важно: эти методы применяются только к обучающей выборке. Если применить их к тестовой, корректная оценка станет невозможной.
Повторная выборка
Повторная выборка (resampling) выравнивает набор данных, добавляя примеры в миноритарный класс или удаляя примеры из мажоритарного. Андерсэмплинг удаляет примеры большинства; оверсэмплинг размножает примеры меньшинства.
Оверсэмплинг
Оверсэмплинг выравнивает данные, размножая примеры миноритарного класса.
Случайный оверсэмплинг:
- Для выравнивания добавляются случайно выбранные примеры меньшинства.
- Подходит, когда набор данных небольшой.
- Может привести к переобучению (overfitting).
RandomOverSampler принимает аргумент sampling_strategy. При sampling_strategy='minority' миноритарный класс размножается, пока не сравняется с мажоритарным. Аргумент принимает и дробное число: если в мажоритарном классе 1000 примеров, а в миноритарном 100, sampling_strategy=0.5 доведёт меньшинство до 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')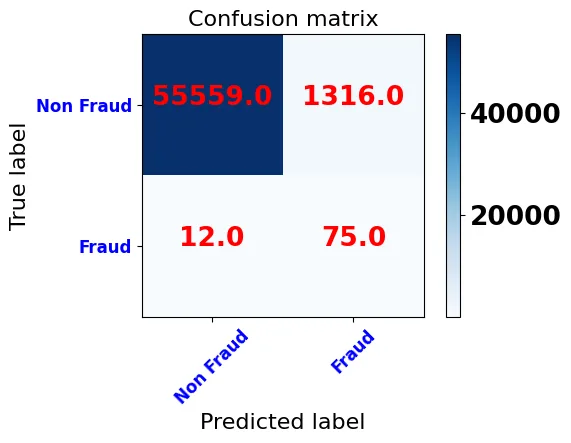
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962После случайного оверсэмплинга доля верных ответов падает до 0,977. Матрица ошибок и отчёт о классификации показывают, что большинство транзакций, помеченных как мошенничество, — ложные тревоги, поэтому точность класса 1 падает до 0,05. Зато полнота класса 1 растёт до 0,86: выявлено 75 из 87 случаев мошенничества. Обычные транзакции предсказываются чуть хуже, чем в первой модели, но этот скачок в выявлении мошенничества — веский довод в пользу модели, обученной после случайного оверсэмплинга.
Оверсэмплинг SMOTE:
Чтобы избежать переобучения, вместо копий создаются синтетические примеры меньшинства:
- Случайно выбирается пример из миноритарного класса.
- Находятся его k ближайших соседей.
- Случайно выбирается один сосед; в пространстве признаков между примером и соседом проводится отрезок, и на нём создаётся синтетический пример.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975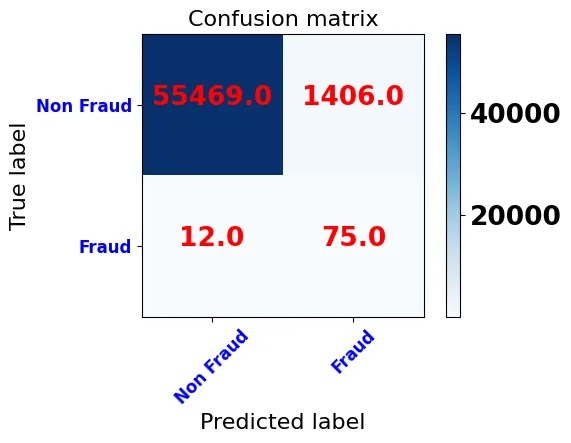
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Результаты после SMOTE похожи на случайный оверсэмплинг: снова выявлено 75 из 87 случаев мошенничества, а ложных тревог становится 1406.
Андерсэмплинг
Андерсэмплинг выравнивает данные, удаляя примеры мажоритарного класса, и подходит для больших наборов. Наш набор недостаточно велик, чтобы они дали хороший результат, но мы объясним методы и покажем, как применяются некоторые из них.
Случайный андерсэмплинг:
- Удаляемые примеры выбираются случайно.
- Подходит, если у вас большой набор данных.
- Случайный выбор может привести к потере информации.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64Андерсэмплинг NearMiss:
- Уменьшает потерю информации.
- Основан на алгоритме KNN.
- Вычисляет расстояние от примеров большинства до примеров меньшинства.
- Сохраняет примеры большинства, ближайшие к меньшинству, по заданному k.
Связи Томека: в каждой паре ближайших примеров из разных классов удаляется пример большинства, и расстояние между двумя классами увеличивается.
Центроиды кластеров: малозначимые примеры удаляются из набора; значимость примера определяется кластеризацией.
Андерсэмплинг и оверсэмплинг можно сочетать, чтобы получить более сбалансированные наборы.
Другие методы
- Сбор дополнительных данных
- Параметр
class_weight, чтобы модель одинаково училась на меньшинстве и большинстве - Сравнение с другими моделями, а не только с одной
- Другой подход, например обнаружение аномалий или изменений
Какой метод сработает лучше, зависит от набора данных. Лучше всего попробовать методы и выбрать тот, что подходит вашим данным.
Источники
- Kaggle: о несбалансированных наборах данных (Yasin Tanış, на турецком)
- Miuul: что такое несбалансированный набор данных (на турецком)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes