

Kaj je neuravnotežena podatkovna zbirka in kako jo obvladati?
Avtor Yasin TANIŞ
Kaj je neuravnotežena podatkovna zbirka
Za neko podjetje izdelate klasifikacijski model, ki doseže 95-odstotno točnost. Vse je videti v redu. Model začnejo uporabljati, kmalu pa nekdo opazi, da vedno napove isti razred. Ko podatke znova pregledate, ugotovite, da razred, ki ga nikoli ne prepozna, predstavlja le 5 % podatkov. Neuspeh modela izvira iz neuravnotežene podatkovne zbirke.
Neuravnotežene zbirke se pojavljajo pri klasifikacijskih problemih, kadar razredi niso niti približno enakomerno porazdeljeni. Težava je, da večinski razred preglasi manjšinskega: model se nagiba k večini in manjšino slabo klasificira.
Ko naletimo na neuravnotežene podatke, lahko pravilno opazujemo in ravnovesje vzpostavimo s temi metodami:
- Izbira pravih metrik: precision, recall, mera F1, krivulja ROC in AUC
- Ponovno vzorčenje: oversampling (naključni in SMOTE) in undersampling (naključni, NearMiss, Tomekove povezave, centroidi gruč)
- Zbiranje več podatkov
- Uporaba parametra
class_weightklasifikacijskih modelov, da se model enako uči iz manjšinskega in večinskega razreda - Preverjanje uspešnosti drugih modelov namesto zanašanja na en sam model
- Uporaba drugačnega pristopa, kot je zaznavanje anomalij ali sprememb
Najprej preučimo neuravnoteženo zbirko Credit Card Fraud Detection, nato pa uporabimo več metod za obvladovanje neravnovesja.
Pregled podatkovne zbirke
Odkrivanje goljufij je pomembno za izdajatelje kreditnih kartic: nočejo, da bi strankam zaračunali nakupe, ki jih niso opravile.
Podatkovna zbirka: creditcard.csv (Kaggle)
S to zbirko želimo zgraditi model, ki odkriva goljufive transakcije. Podatki izvirajo iz transakcij s karticami, opravljenih v Evropi septembra 2013; vsaka transakcija je označena z 1, če je goljufija, in z 0, če ni. Zaradi varstva zasebnosti je informacij o ozadju malo, vse spremenljivke razen Time in Amount pa so preoblikovane z metodo PCA (analiza glavnih komponent).
Time: število sekund, ki so pretekle med prvo transakcijo in posamezno transakcijoAmount: znesek transakcije
Najprej preberemo podatke, preverimo manjkajoče vrednosti in pogledamo porazdelitev spremenljivke Class. Nato standardiziramo Amount in Time, podatke razdelimo z metodo hold-out in z logistično regresijo zgradimo klasifikacijski model. Delali bomo z enim modelom.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()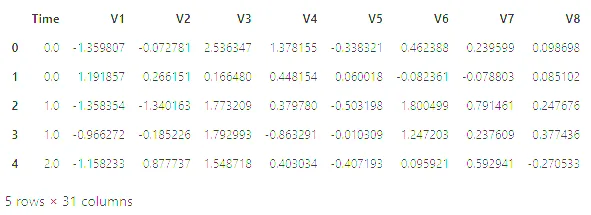
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Koda izpiše oznake v turščini: število opazovanj in število spremenljivk.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()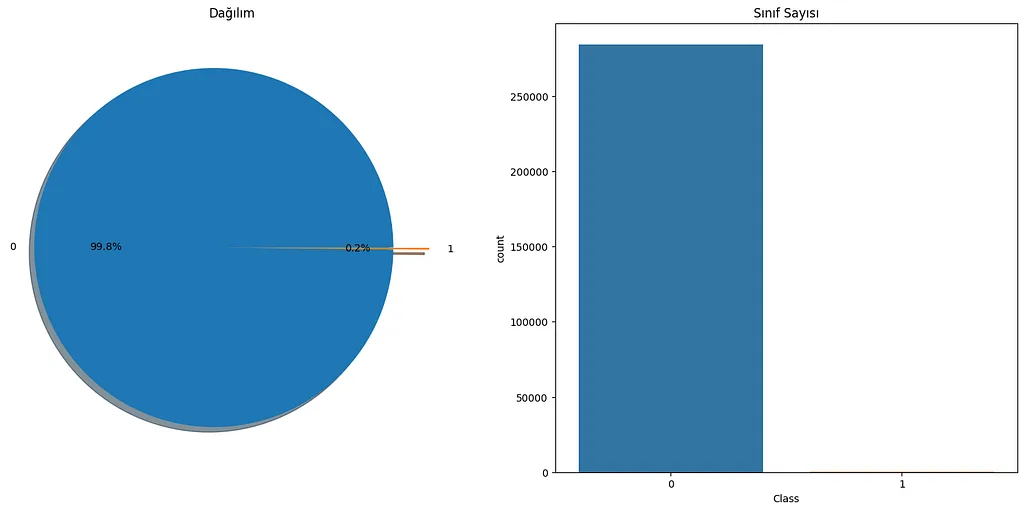
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()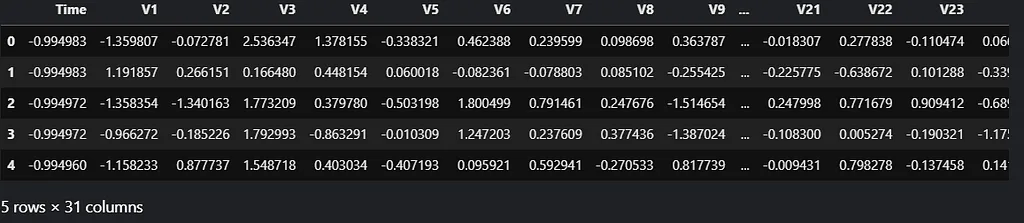
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Točnost je delež pravilnih napovedi med vsemi napovedmi. Naš model doseže 0,999. Lahko bi rekli, da deluje brezhibno, kajne? Poglejmo še matriko zmede.
Matrika zmede
Matrika zmede je tabela, ki povzema, kako klasifikacijski model deluje na testnih podatkih. Vsebuje štiri kombinacije napovedanih in dejanskih vrednosti. Goljufijo tu obravnavamo kot pozitivni razred:
- Resnično pozitivno (TP): napovedano pozitivno in pravilno.
- Resnično negativno (TN): napovedano negativno in pravilno.
- Lažno pozitivno (FP): napovedano pozitivno, a napačno.
- Lažno negativno (FN): napovedano negativno, a napačno.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')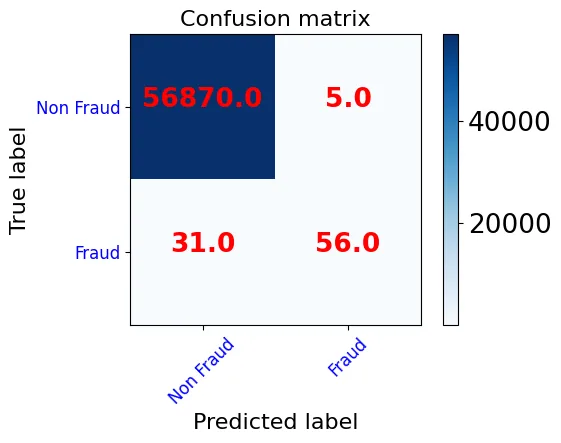
- Od 56875 dejansko običajnih transakcij jih je 56870 napovedanih pravilno, 5 pa napačno označenih kot goljufija (FP).
- Od 87 dejanskih goljufij jih je 56 ujetih (TP), 31 pa spregledanih (FN).
Model navaja točnost 0,999, a matrika zmede kaže visoko stopnjo napak v razredu goljufij. Model dobro napoveduje večinski in slabo manjšinski razred. Ker je običajnih transakcij veliko več kot goljufivih, je model videti uspešen že zato, ker napoveduje običajni razred.
Nauk: točnost ni dobro merilo uspešnosti klasifikacijskih modelov, zlasti kadar so podatki tako neuravnoteženi kot naši. Poglejmo, kako obvladati neravnovesje, katere metode uporabiti in s katerimi metrikami meriti uspešnost.
Izbira pravih metrik
Videli smo, da točnost ne zadošča; za merjenje uspešnosti potrebujemo druge metrike.
Precision (natančnost): delež napovedanih pozitivnih, ki so res pozitivni. Nizka natančnost pomeni veliko lažno pozitivnih. Precision = TP / (TP + FP).
Recall (priklic): delež dejansko pozitivnih, ki smo jih napovedali kot pozitivne. Nizek priklic pomeni veliko lažno negativnih; biti mora čim višji. Recall = TP / (TP + FN).
Mera F1: težko je primerjati model z nizko natančnostjo in visokim priklicem z modelom, pri katerem je ravno obratno. F1 meri oboje hkrati kot harmonično sredino natančnosti in priklica. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Poglejmo te metrike za naš model. Poročilo o klasifikaciji prikazuje glavne metrike po razredih.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))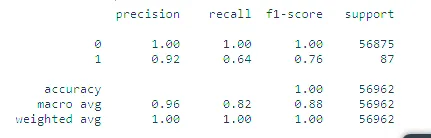
Natančnost po razredih:
- Razred 0 (običajno): 56870 + 31 = 56901 transakcij je napovedanih kot običajne, od tega 56870 pravilno. Precision ≈ 1,00 (56870 / 56901).
- Razred 1 (goljufija): 5 + 56 = 61 transakcij je napovedanih kot goljufija, od tega 56 pravilno. Precision ≈ 0,92 (56 / 61).
Priklic po razredih:
- Razred 0 (običajno): od 56870 + 5 = 56875 običajnih transakcij jih je 56870 napovedanih pravilno. Recall ≈ 1,00.
- Razred 1 (goljufija): od 31 + 56 = 87 goljufivih transakcij jih je 56 napovedanih pravilno. Recall = 56 / 87 ≈ 0,64.
Vrednosti priklica jasno pokažejo neuspeh pri razredu 1. Mera F1 je harmonična sredina priklica in natančnosti. Support je dejansko število primerov v vsakem razredu; razlika med razredi kaže strukturno šibkost meritev, saj nanje vpliva že samo neravnovesje.
Krivulja ROC
Krivulja ROC prikazuje uspešnost klasifikacijskega modela pri vseh odločitvenih pragovih. Prikazuje dve vrednosti:
- Delež resnično pozitivnih (TPR), torej priklic: TPR = TP / (TP + FN)
- Delež lažno pozitivnih (FPR), torej lažnih alarmov pri običajnih transakcijah: FPR = FP / (FP + TN)
Krivulja prikazuje TPR glede na FPR pri različnih pragovih; začne se v (0,0) in konča v (1,1). Dober model da krivuljo, ki se hitro dvigne od 0 do 1.
AUC (ploščina pod krivuljo ROC)
AUC povzame krivuljo ROC z eno številko: meri celotno ploščino pod krivuljo od (0,0) do (1,1). Najboljša vrednost je 1; naključno ugibanje da 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)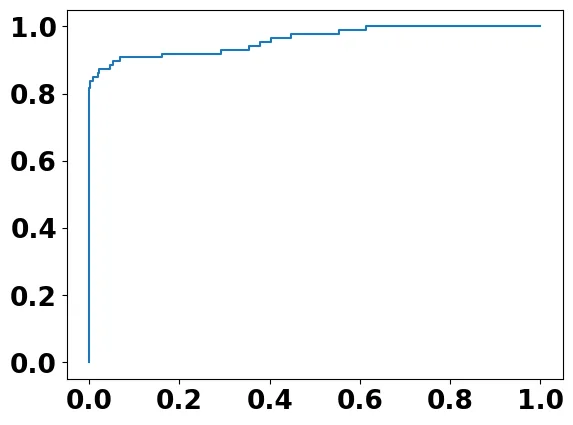
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Opomba: AUC ocenjuje splošno klasifikacijsko uspešnost. Ker nobenemu razredu ne daje večje teže, uspešnosti pri manjšinskem razredu ne odraža dobro.
Zdaj na zbirki uporabimo več metod, da odpravimo neravnovesje.
Pomembno: te metode je treba uporabiti samo na učni množici. Če jih uporabimo na testni množici, pravilno ovrednotenje ni mogoče.
Ponovno vzorčenje
Ponovno vzorčenje (resampling) uravnoteži zbirko tako, da manjšinskemu razredu doda nove primere ali večinskemu razredu primere odvzame. Undersampling odstrani primere večine; oversampling namnoži primere manjšine.
Oversampling
Oversampling uravnoteži podatke z množenjem primerov manjšinskega razreda.
Naključni oversampling:
- Za uravnoteženje se dodajo naključno izbrani primeri manjšinskega razreda.
- Uporaben je, kadar je zbirka majhna.
- Lahko povzroči prekomerno prilagajanje (overfitting).
RandomOverSampler sprejme argument sampling_strategy. Z sampling_strategy='minority' se manjšinski razred množi, dokler ne doseže večinskega. Argument sprejme tudi decimalno število: če ima večinski razred 1000 primerov, manjšinski pa 100, sampling_strategy=0.5 dvigne manjšinskega na 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')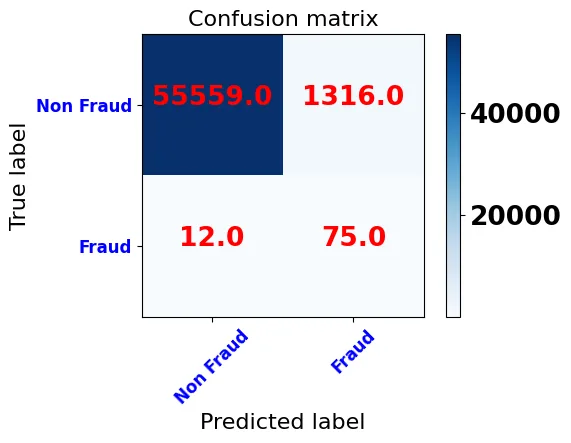
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Po naključnem oversamplingu točnost modela pade na 0,977. Matrika zmede in poročilo o klasifikaciji kažeta, da gre pri večini transakcij, označenih kot goljufija, za lažne alarme, zato natančnost razreda 1 pade na 0,05. V zameno priklic razreda 1 naraste na 0,86: ujetih je 75 od 87 goljufij. Običajne transakcije so napovedane nekoliko slabše kot pri prvem modelu, a ta skok pri odkrivanju goljufij je močan razlog, da izberemo model, naučen po naključnem oversamplingu.
SMOTE oversampling:
Da se izognemo prekomernemu prilagajanju, namesto kopij ustvarimo sintetične primere manjšinskega razreda:
- Naključno izberemo primer iz manjšinskega razreda.
- Poiščemo njegovih k najbližjih sosedov.
- Naključno izberemo enega soseda; v prostoru značilk med primerom in sosedom potegnemo daljico, sintetični primer pa nastane na tej daljici.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975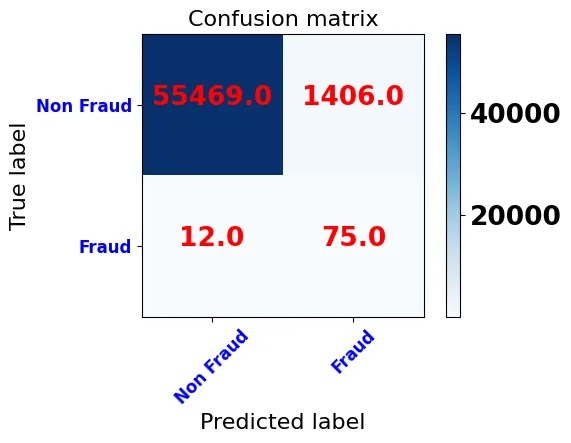
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Rezultati po SMOTE so podobni naključnemu oversamplingu: spet je ujetih 75 od 87 goljufij, število lažnih alarmov pa naraste na 1406.
Undersampling
Undersampling uravnoteži podatke z odstranjevanjem primerov večinskega razreda in je primeren za velike zbirke. Naša zbirka ni dovolj velika, da bi ta pristop dobro deloval, a metode vseeno razložimo in pokažemo, kako uporabimo nekatere od njih.
Naključni undersampling:
- Primeri za odstranitev so izbrani naključno.
- Uporaben je, če imate veliko zbirko.
- Naključna izbira lahko povzroči izgubo informacij.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss undersampling:
- Zmanjša izgubo informacij.
- Temelji na algoritmu KNN.
- Izračuna razdaljo primerov večinskega razreda do primerov manjšinskega.
- Glede na podani k ohrani primere večinskega razreda, ki so najbližje manjšinskemu.
Tomekove povezave: za vsak par najbližjih primerov iz različnih razredov odstranimo primer večinskega razreda in tako povečamo razmik med razredoma.
Centroidi gruč: nepomembne primere odstranimo iz zbirke; ali je primer pomemben, določi gručenje.
Undersampling in oversampling lahko združimo in tako dobimo bolj uravnotežene zbirke.
Druge metode
- Zbiranje več podatkov
- Uporaba parametra
class_weight, da se model enako uči iz manjšinskega in večinskega razreda - Preverjanje uspešnosti drugih modelov, ne le enega
- Uporaba drugačnega pristopa, kot je zaznavanje anomalij ali sprememb
Katera metoda da najboljši rezultat, je odvisno od zbirke. Najbolje je metode preizkusiti in izbrati tisto, ki ustreza vašim podatkom.
Viri
- Kaggle: O neuravnoteženih podatkovnih zbirkah (Yasin Tanış, v turščini)
- Miuul: Kaj je neuravnotežena podatkovna zbirka (v turščini)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes