

Що таке незбалансований набір даних і як із ним працювати?
Автор: Yasin TANIŞ
Що таке незбалансований набір даних
Ви будуєте для бізнесу модель класифікації, і вона дає точність 95 %. Усе виглядає добре. Модель запускають, і невдовзі хтось помічає, що вона завжди передбачає той самий клас. Переглянувши дані ще раз, ви бачите: клас, який вона ніколи не розпізнає, становить лише 5 % даних. Провал моделі спричинений незбалансованим набором даних.
Незбалансовані набори даних трапляються в задачах класифікації, коли класи розподілені далеко не порівну. Проблема в тому, що мажоритарний клас заглушає міноритарний: модель хилиться до більшості й погано класифікує меншість.
Коли ми маємо справу з незбалансованими даними, правильно оцінювати ситуацію й відновлювати баланс допомагають такі методи:
- Вибір правильних метрик: precision, recall, F1-міра, ROC-крива та AUC
- Повторна вибірка: оверсемплінг (випадковий і SMOTE) та андерсемплінг (випадковий, NearMiss, зв’язки Томека, центроїди кластерів)
- Збір додаткових даних
- Використання параметра
class_weightмоделей класифікації, щоб модель однаково навчалася на прикладах міноритарного й мажоритарного класів - Оцінювання якості інших моделей замість того, щоб покладатися на одну
- Інший підхід, наприклад виявлення аномалій або змін
Спершу ми розглянемо незбалансований набір Credit Card Fraud Detection, а потім застосуємо кілька методів, щоб упоратися з дисбалансом.
Дослідження набору даних
Виявляти шахрайство важливо для компаній — емітентів кредитних карток: вони не хочуть списувати з клієнтів гроші за покупки, яких ті не робили.
Набір даних: creditcard.csv (Kaggle)
На цьому наборі ми хочемо побудувати модель, що виявляє шахрайські транзакції. Дані взято з транзакцій за кредитними картками, здійснених у Європі у вересні 2013 року; кожна транзакція позначена 1, якщо це шахрайство, і 0, якщо ні. З міркувань конфіденційності додаткової інформації небагато, а всі змінні, крім Time і Amount, перетворено методом PCA (метод головних компонент).
Time: секунди від першої транзакції до кожної транзакціїAmount: сума транзакції
Спершу зчитуємо дані, перевіряємо пропущені значення й дивимося розподіл змінної Class. Потім стандартизуємо Amount і Time, розділяємо дані методом hold-out (відкладена вибірка) і будуємо модель класифікації на логістичній регресії. Працюватимемо з однією моделлю.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()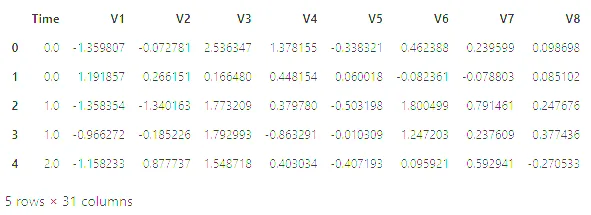
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Код друкує підписи турецькою: кількість спостережень і кількість змінних.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()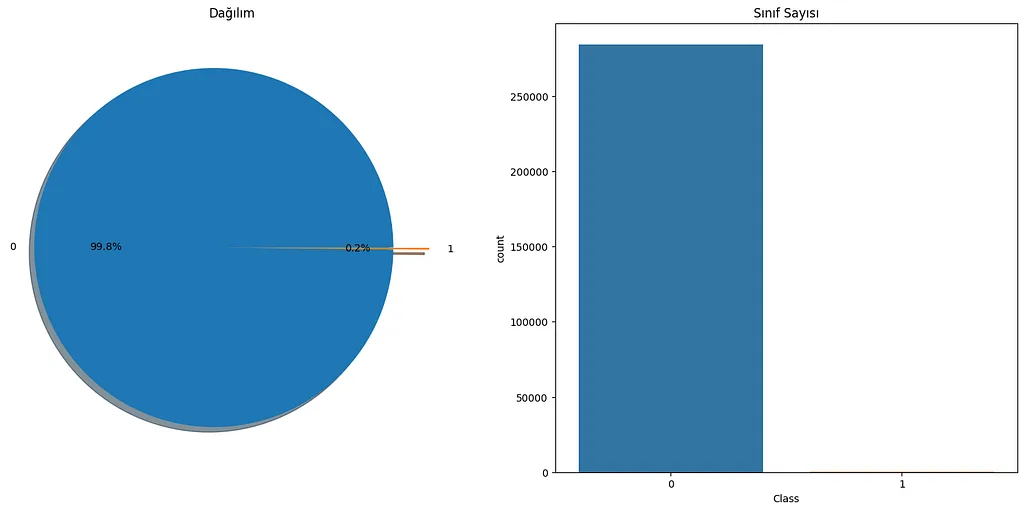
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()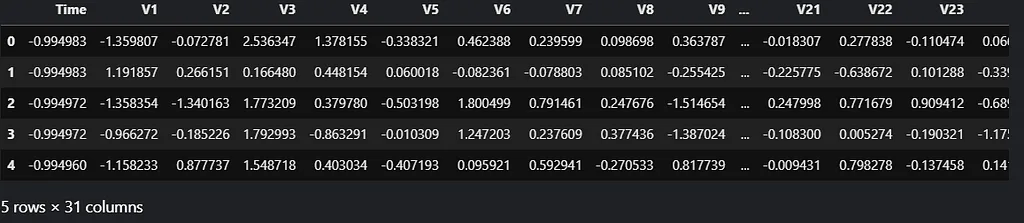
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Частка правильних відповідей (accuracy) — це відношення правильних передбачень до всіх. Наша модель дає 0,999. Можна сказати, що вона працює ідеально, чи не так? Погляньмо й на матрицю помилок.
Матриця помилок
Матриця помилок (confusion matrix) — таблиця, що показує, як модель класифікації працює на тестових даних. У ній чотири поєднання передбачених і справжніх значень. Тут шахрайство вважаємо позитивним класом:
- Істинно позитивний (TP): модель передбачила позитивний клас, і це правильно.
- Істинно негативний (TN): модель передбачила негативний клас, і це правильно.
- Хибнопозитивний (FP): модель передбачила позитивний клас, але помилилася.
- Хибнонегативний (FN): модель передбачила негативний клас, але помилилася.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')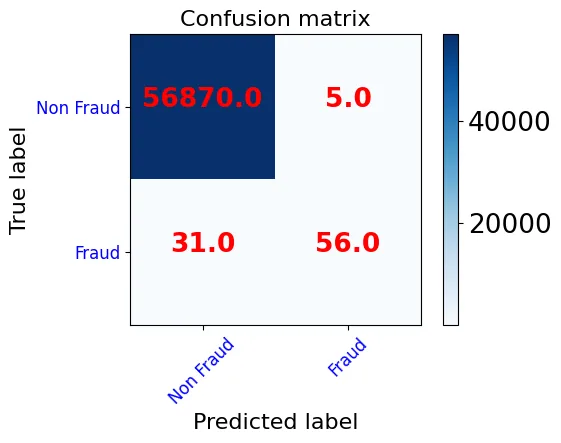
- Із 56875 справді звичайних транзакцій 56870 передбачено правильно, а 5 помилково позначено як шахрайство (FP).
- Із 87 справжніх випадків шахрайства 56 виявлено (TP), а 31 пропущено (FN).
Модель заявляє точність 0,999, але матриця помилок показує високу частку помилок у класі шахрайства. Модель добре передбачає мажоритарний клас і погано — міноритарний. Оскільки звичайних транзакцій набагато більше, ніж шахрайських, модель виглядає успішною просто тому, що передбачає звичайний клас.
Висновок: частка правильних відповідей — погана міра якості для моделей класифікації, особливо на таких незбалансованих даних, як наші. Погляньмо, як упоратися з дисбалансом, які методи застосувати й якими метриками вимірювати якість.
Вибір правильних метрик
Ми побачили, що частки правильних відповідей недостатньо; щоб виміряти якість, потрібні інші метрики.
Precision (влучність): частка передбачених позитивних, які справді позитивні. Низька влучність означає багато хибних спрацювань. Precision = TP / (TP + FP).
Recall (повнота): частка справді позитивних, які ми передбачили як позитивні. Низька повнота означає багато пропусків; вона має бути якомога вищою. Recall = TP / (TP + FN).
F1-міра: модель із низькою влучністю й високою повнотою важко порівняти з протилежною. F1 вимірює обидві величини разом як гармонічне середнє влучності й повноти. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Погляньмо на ці метрики для нашої моделі. Звіт про класифікацію показує основні метрики за класами.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))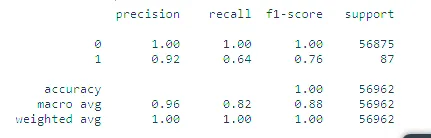
Влучність за класами:
- Клас 0 (звичайні): 56870 + 31 = 56901 транзакцію передбачено як звичайні, з них 56870 правильно. Precision ≈ 1,00 (56870 / 56901).
- Клас 1 (шахрайство): 5 + 56 = 61 транзакцію передбачено як шахрайство, з них 56 правильно. Precision ≈ 0,92 (56 / 61).
Повнота за класами:
- Клас 0 (звичайні): із 56870 + 5 = 56875 звичайних транзакцій 56870 передбачено правильно. Recall ≈ 1,00.
- Клас 1 (шахрайство): із 31 + 56 = 87 шахрайських транзакцій 56 передбачено правильно. Recall = 56 / 87 ≈ 0,64.
Значення повноти чітко показують провал на класі 1. F1-міра — гармонічне середнє повноти й влучності. Support — справжня кількість прикладів у кожному класі; різниця між класами показує структурну слабкість вимірювань, адже на них впливає сам дисбаланс.
ROC-крива
ROC-крива показує якість моделі класифікації за всіх порогів рішення. На ній відкладають дві величини:
- Частка істинно позитивних (TPR), тобто повнота: TPR = TP / (TP + FN)
- Частка хибнопозитивних (FPR), тобто хибних тривог на звичайних транзакціях: FPR = FP / (FP + TN)
Крива відображає залежність TPR від FPR за різних порогів; вона починається в (0,0) і закінчується в (1,1). Добра модель дає криву, що швидко піднімається від 0 до 1.
AUC (площа під ROC-кривою)
AUC зводить ROC-криву до одного числа: вимірює всю площу під кривою від (0,0) до (1,1). Найкраще значення — 1; випадкове вгадування дає 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)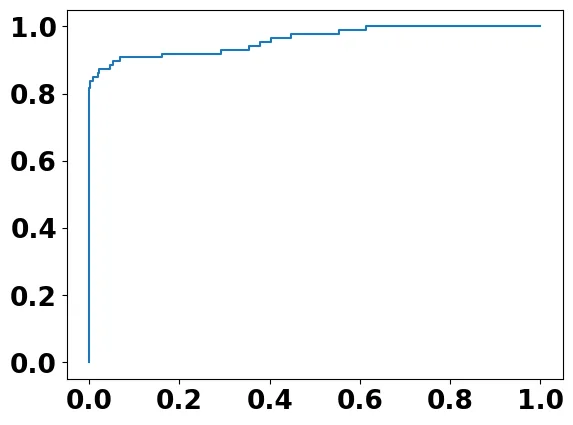
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Примітка: AUC оцінює загальну якість класифікації. Оскільки вона не надає більшої ваги жодному класу, то погано відображає якість на міноритарному класі.
Тепер застосуймо до набору даних кілька методів, щоб усунути дисбаланс.
Важливо: ці методи застосовують лише до навчальної вибірки. Якщо застосувати їх до тестової, коректна оцінка стане неможливою.
Повторна вибірка
Повторна вибірка (resampling) вирівнює набір даних, додаючи приклади до міноритарного класу або вилучаючи приклади з мажоритарного. Андерсемплінг вилучає приклади більшості; оверсемплінг розмножує приклади меншості.
Оверсемплінг
Оверсемплінг вирівнює дані, розмножуючи приклади міноритарного класу.
Випадковий оверсемплінг:
- Для вирівнювання додаються випадково вибрані приклади меншості.
- Підходить, коли набір даних невеликий.
- Може призвести до перенавчання (overfitting).
RandomOverSampler приймає аргумент sampling_strategy. Якщо sampling_strategy='minority', міноритарний клас розмножується, доки не зрівняється з мажоритарним. Аргумент приймає й дробове число: якщо в мажоритарному класі 1000 прикладів, а в міноритарному 100, sampling_strategy=0.5 збільшить міноритарний клас до 500 прикладів.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')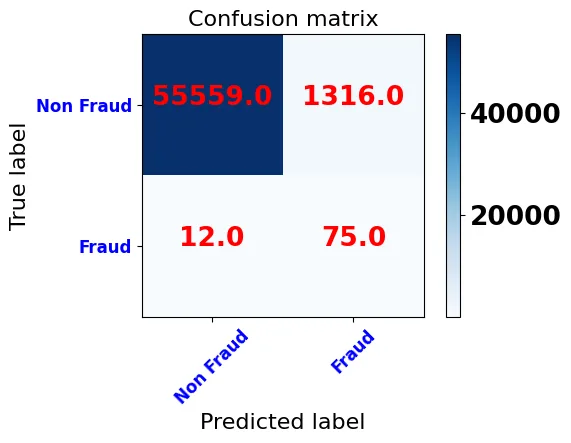
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Після випадкового оверсемплінгу частка правильних відповідей падає до 0,977. Матриця помилок і звіт про класифікацію показують, що більшість транзакцій, позначених як шахрайство, — хибні тривоги, тож влучність класу 1 падає до 0,05. Натомість повнота класу 1 зростає до 0,86: виявлено 75 із 87 випадків шахрайства. Звичайні транзакції модель передбачає трохи гірше, ніж у першій моделі, але цей стрибок у виявленні шахрайства — вагомий аргумент на користь моделі, навченої після випадкового оверсемплінгу.
Оверсемплінг SMOTE:
Щоб уникнути перенавчання, замість копій створюють синтетичні приклади меншості:
- Випадково вибирають приклад із міноритарного класу.
- Знаходять його k найближчих сусідів.
- Випадково вибирають одного сусіда; у просторі ознак між прикладом і сусідом проводять відрізок, і на ньому створюють синтетичний приклад.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975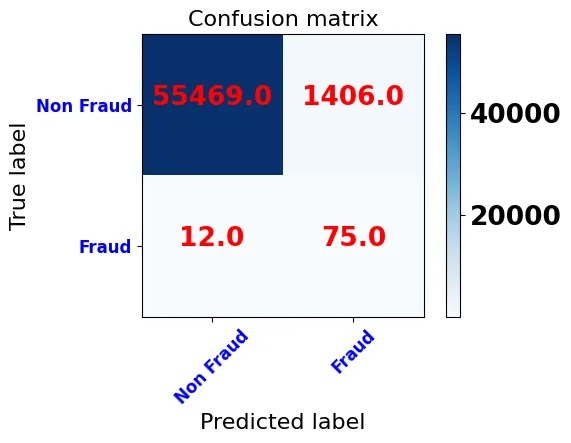
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Результати після SMOTE схожі на випадковий оверсемплінг: знову виявлено 75 із 87 випадків шахрайства, а хибних тривог стає 1406.
Андерсемплінг
Андерсемплінг вирівнює дані, вилучаючи приклади мажоритарного класу, і підходить для великих наборів. Наш набір недостатньо великий, щоб цей підхід дав добрі результати, але ми пояснимо методи й покажемо, як застосовують деякі з них.
Випадковий андерсемплінг:
- Приклади для вилучення вибирають випадково.
- Підходить, якщо у вас великий набір даних.
- Випадковий вибір може призвести до втрати інформації.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64Андерсемплінг NearMiss:
- Зменшує втрату інформації.
- Ґрунтується на алгоритмі KNN.
- Обчислює відстань від прикладів більшості до прикладів меншості.
- Зберігає приклади більшості, найближчі до меншості, за заданим k.
Зв’язки Томека: у кожній парі найближчих прикладів із різних класів вилучають приклад більшості, і проміжок між класами зростає.
Центроїди кластерів: малозначущі приклади вилучають із набору; значущість прикладу визначає кластеризація.
Андерсемплінг і оверсемплінг можна поєднувати, щоб отримати збалансованіші набори.
Інші методи
- Збір додаткових даних
- Використання параметра
class_weight, щоб модель однаково навчалася на прикладах міноритарного й мажоритарного класів - Оцінювання якості інших моделей, а не лише однієї
- Інший підхід, наприклад виявлення аномалій або змін
Який метод спрацює найкраще, залежить від набору даних. Найкращий результат дає перевірка різних методів і вибір того, що підходить саме вашим даним.
Джерела
- Kaggle: про незбалансовані набори даних (Yasin Tanış, турецькою)
- Miuul: що таке незбалансований набір даних (турецькою)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes