

Шта је неуравнотежен скуп података и како се носити с њим?
Аутор Yasin TANIŞ
Шта је неуравнотежен скуп података
Правите класификациони модел за неку компанију и он постиже тачност од 95 %. Све изгледа у реду. Модел улази у употребу, а убрзо неко примети да увек предвиђа исту класу. Кад поново погледате податке, видите да класа коју никад не препознаје чини свега 5 % података. Неуспех модела потиче од неуравнотеженог скупа података.
Неуравнотежени скупови података јављају се у проблемима класификације када класе нису ни приближно равномерно распоређене. Проблем је што већинска класа надјачава мањинску: модел нагиње већини и лоше класификује мањину.
Кад се суочимо с неуравнотеженим подацима, ово су методе којима можемо исправно сагледати стање и вратити равнотежу:
- Избор правих метрика: precision, recall, F1 мера, ROC крива и AUC
- Поновно узорковање: оверсемплинг (oversampling: насумични и SMOTE) и андерсемплинг (undersampling: насумични, NearMiss, Томекове везе, центроиди кластера)
- Прикупљање више података
- Коришћење параметра
class_weightкласификационих модела, како би модел подједнако учио из мањинске и већинске класе - Провера перформанси других модела уместо ослањања на један
- Примена другачијег приступа, попут откривања аномалија или промена
Прво ћемо испитати скуп података Credit Card Fraud Detection, који је неуравнотежен, а затим ћемо применити више метода како бисмо се изборили с том неравнотежом.
Испитивање скупа података
Откривање превара важно је компанијама које издају кредитне картице: оне не желе да купцима наплате куповине које ти купци нису обавили.
Скуп података: creditcard.csv (Kaggle)
Помоћу овог скупа желимо да направимо модел који открива преварне трансакције. Подаци потичу од трансакција картицама у Европи у септембру 2013. године; свака трансакција означена је са 1 ако је превара, а са 0 ако није. Из разлога приватности позадинских информација је мало, а све променљиве осим Time и Amount трансформисане су методом PCA (анализа главних компоненти).
Time: број секунди протеклих између прве трансакције и дате трансакцијеAmount: износ трансакције
Прво читамо податке, проверавамо недостајуће вредности и посматрамо расподелу променљиве Class. Затим стандардизујемо Amount и Time, делимо податке hold-out методом и правимо класификациони модел логистичком регресијом. Радићемо с једним моделом.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()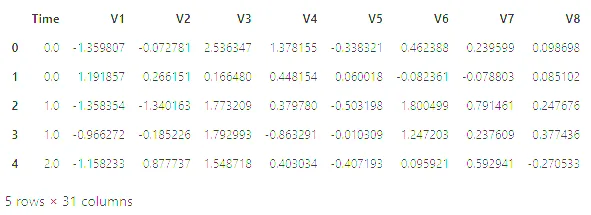
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Код исписује ознаке на турском: број опсервација и број променљивих.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()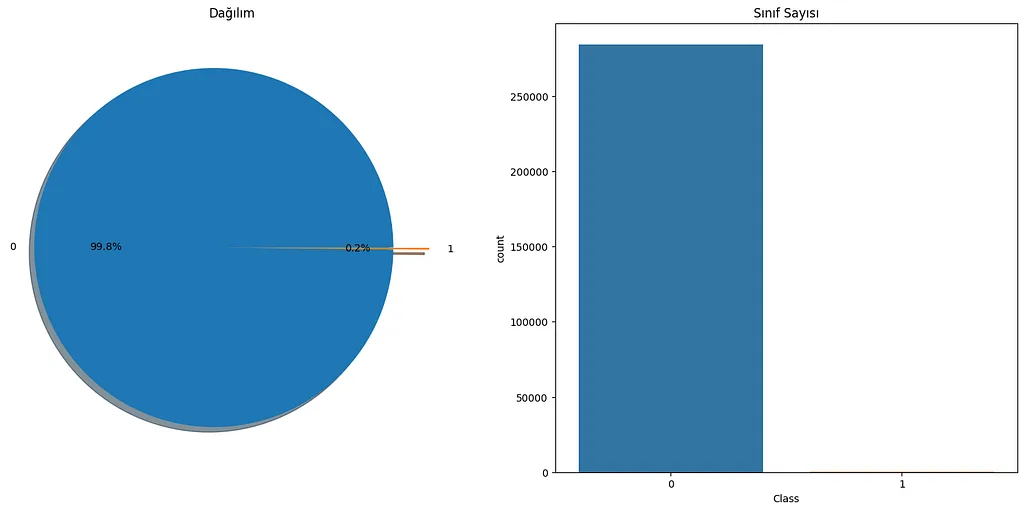
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()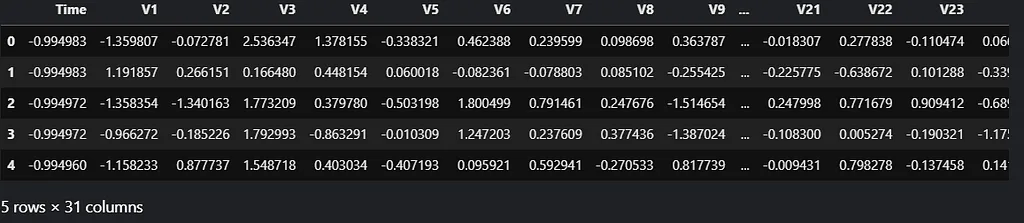
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Тачност је удео тачних предвиђања у свим предвиђањима. Наш модел постиже 0,999. Могли бисмо рећи да ради савршено, зар не? Погледајмо и матрицу конфузије.
Матрица конфузије
Матрица конфузије је табела која сажима какве резултате класификациони модел постиже на тест подацима. Садржи четири комбинације предвиђених и стварних вредности. Овде превару сматрамо позитивном класом:
- Стварно позитивни (TP): предвиђање је позитивно и тачно.
- Стварно негативни (TN): предвиђање је негативно и тачно.
- Лажно позитивни (FP): предвиђање је позитивно, али погрешно.
- Лажно негативни (FN): предвиђање је негативно, али погрешно.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')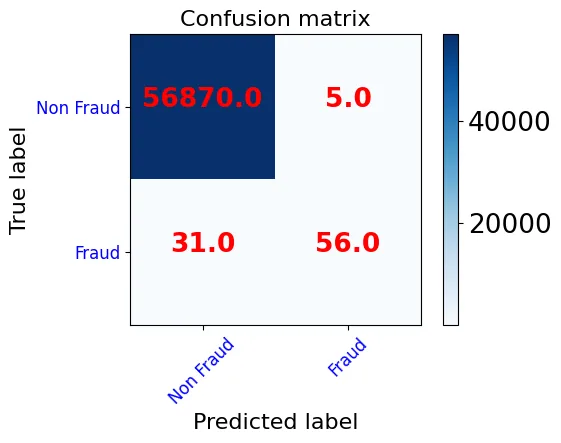
- Од 56875 трансакција које су стварно нормалне, 56870 предвиђено је тачно, а 5 погрешно означено као превара (FP).
- Од 87 трансакција које су стварно преваре, 56 је откривено (TP), а 31 је пропуштена (FN).
Модел исказује тачност од 0,999, али матрица конфузије показује високу стопу грешака у класи превара. Модел добро предвиђа већинску, а лоше мањинску класу. Пошто нормалних трансакција има много више од преварних, модел изгледа успешно самим тим што предвиђа нормалну класу.
Поука: тачност није добра мера перформанси класификационих модела, нарочито кад су подаци неуравнотежени као наши. Погледајмо како се носити с неравнотежом, које методе применити и којим метрикама мерити перформансе.
Избор правих метрика
Видели смо да тачност није довољна; за мерење перформанси потребне су друге метрике.
Precision (прецизност): удео стварно позитивних међу онима који су предвиђени као позитивни. Ниска прецизност значи много лажно позитивних. Precision = TP / (TP + FP).
Recall (одзив): удео стварно позитивних које смо предвидели као позитивне. Низак одзив значи много лажно негативних; треба да буде што виши. Recall = TP / (TP + FN).
F1 мера: тешко је поредити модел ниске прецизности и високог одзива с моделом обрнутих особина. F1 мера обухвата обе вредности истовремено, као хармонијска средина прецизности и одзива. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Погледајмо ове метрике за наш модел. Извештај о класификацији приказује главне метрике по класама.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))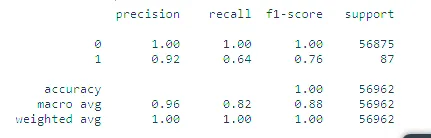
Прецизност по класама:
- Класа 0 (нормално): 56870 + 31 = 56901 трансакција предвиђена је као нормална, од тога 56870 тачно. Precision ≈ 1,00 (56870 / 56901).
- Класа 1 (превара): 5 + 56 = 61 трансакција предвиђена је као превара, од тога 56 тачно. Precision ≈ 0,92 (56 / 61).
Одзив по класама:
- Класа 0 (нормално): од 56870 + 5 = 56875 нормалних трансакција, 56870 предвиђено је тачно. Recall ≈ 1,00.
- Класа 1 (превара): од 31 + 56 = 87 преварних трансакција, 56 предвиђено је тачно. Recall = 56 / 87 ≈ 0,64.
Вредности одзива јасно показују неуспех на класи 1. F1 мера је хармонијска средина одзива и прецизности. Support је стварни број примера у свакој класи; разлика међу класама показује структурну слабост мерења, јер сама неравнотежа утиче на њих.
ROC крива
ROC крива приказује перформансе класификационог модела на свим праговима одлучивања. На њој се приказују две вредности:
- Стопа стварно позитивних (TPR), тј. одзив: TPR = TP / (TP + FN)
- Стопа лажно позитивних (FPR), тј. лажних узбуна на нормалним трансакцијама: FPR = FP / (FP + TN)
Крива приказује TPR наспрам FPR на различитим праговима; почиње у тачки (0,0), а завршава се у (1,1). Добар модел даје криву која брзо расте од 0 до 1.
AUC (површина испод ROC криве)
AUC сажима ROC криву једним бројем: мери целу површину испод криве од (0,0) до (1,1). Најбоља вредност је 1; насумично погађање даје 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)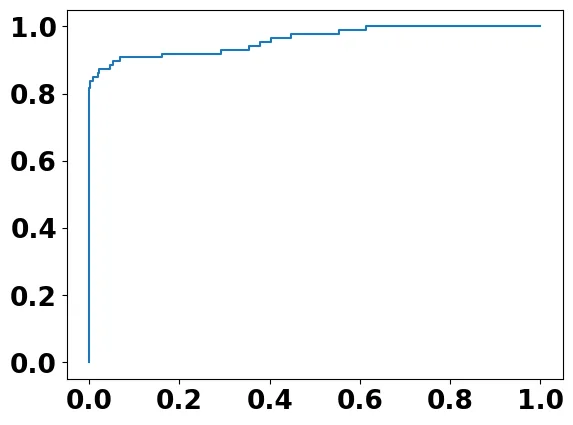
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Напомена: AUC оцењује укупне перформансе класификације. Пошто ниједној класи не даје већу тежину, не одражава добро перформансе на мањинској класи.
Применимо сада на скуп података неколико метода како бисмо отклонили неравнотежу.
Важно: ове методе примењују се само на скуп за обуку. Примењене на тест скуп, онемогућавају исправну процену.
Поновно узорковање
Поновно узорковање (resampling) уравнотежује скуп података додавањем нових примера мањинској класи или уклањањем примера из већинске. Андерсемплинг уклања примере већине; оверсемплинг умножава примере мањине.
Оверсемплинг
Оверсемплинг уравнотежује податке умножавањем примера мањинске класе.
Насумични оверсемплинг:
- Насумично изабрани примери мањинске класе додају се да би се скуп уравнотежио.
- Може се користити кад је скуп података мали.
- Може довести до преприлагођавања (overfitting).
RandomOverSampler прима аргумент sampling_strategy. Уз sampling_strategy='minority' мањинска класа се умножава док не достигне већинску. Аргумент прима и децимални број: ако већинска класа има 1000 примера, а мањинска 100, sampling_strategy=0.5 подиже мањинску на 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')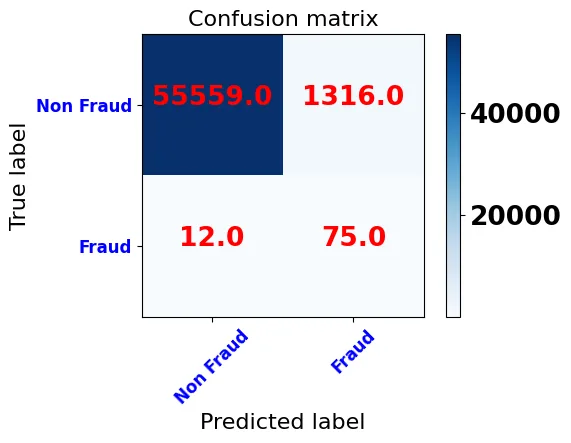
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Након насумичног оверсемплинга тачност модела пада на 0,977. Матрица конфузије и извештај о класификацији показују да је већина трансакција означених као превара лажна узбуна, што прецизност класе 1 спушта на 0,05. Заузврат, одзив класе 1 расте на 0,86: откривено је 75 од 87 превара. Нормалне трансакције предвиђају се нешто лошије него код првог модела, али овај скок у откривању превара снажан је разлог да се предност да моделу обученом након насумичног оверсемплинга.
SMOTE оверсемплинг:
Да би се избегло преприлагођавање, уместо копија генеришу се синтетички примери мањинске класе:
- Насумично се бира један пример мањинске класе.
- Проналази се његових k најближих суседа.
- Један сусед бира се насумично; у простору обележја повлачи се дуж између примера и тог суседа, а синтетички пример настаје на тој дужи.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975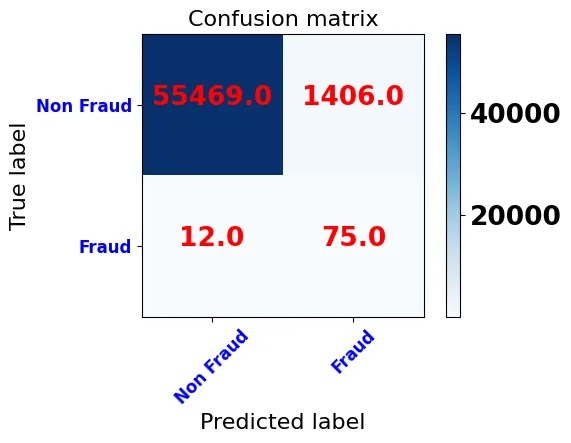
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Резултати након SMOTE-а слични су насумичном оверсемплингу: поново је откривено 75 од 87 превара, док број лажних узбуна расте на 1406.
Андерсемплинг
Андерсемплинг уравнотежује податке уклањањем примера из већинске класе и погодан је за велике скупове. Наш скуп није довољно велик да би ова метода дала добре резултате, али објашњавамо методе и показујемо како се неке примењују.
Насумични андерсемплинг:
- Примери за уклањање бирају се насумично.
- Може се користити ако имате велик скуп података.
- Насумични избор може довести до губитка информација.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss андерсемплинг:
- Смањује губитак информација.
- Заснива се на алгоритму KNN.
- Рачуна удаљеност примера већинске класе од примера мањинске.
- Задржава примере већинске класе најближе мањинској, према задатом k.
Томекове везе: за сваки пар најближих примера из различитих класа уклања се пример већинске класе, чиме се повећава размак између класа.
Центроиди кластера: неважни примери уклањају се из скупа; да ли је пример важан одређује се кластеровањем.
Андерсемплинг и оверсемплинг могу се комбиновати да би се добили уравнотеженији скупови података.
Друге методе
- Прикупљање више података
- Коришћење параметра
class_weight, како би модел подједнако учио из мањинске и већинске класе - Провера перформанси других модела, а не само једног
- Примена другачијег приступа, попут откривања аномалија или промена
Која метода даје најбољи резултат зависи од скупа података. Најбоље је испробати методе и изабрати ону која одговара вашим подацима.
Извори
- Kaggle: О неуравнотеженим скуповима података (Yasin Tanış, на турском)
- Miuul: Шта је неуравнотежен скуп података (на турском)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes