

Che cos’è un dataset sbilanciato e come si affronta?
Scritto da Yasin TANIŞ
Che cos’è un dataset sbilanciato
Costruisci un modello di classificazione per un’azienda e ottieni il 95% di accuratezza. Sembra tutto a posto. Il modello entra in funzione e presto qualcuno nota che prevede sempre la stessa classe. Riguardando i dati, scopri che la classe che non riconosce mai rappresenta appena il 5% dei dati. Il fallimento del modello dipende da un dataset sbilanciato.
I dataset sbilanciati compaiono nei problemi di classificazione quando le classi sono tutt’altro che distribuite in modo uniforme. Il problema è che la classe maggioritaria soffoca quella minoritaria: il modello tende a favorire la classe maggioritaria e classifica male quella minoritaria.
Quando abbiamo a che fare con dati sbilanciati, questi sono i metodi che possiamo usare per osservare correttamente e ripristinare l’equilibrio:
- Scegliere le metriche giuste: precisione, richiamo (recall), punteggio F1, curva ROC e AUC
- Ricampionare: oversampling (casuale e SMOTE) e undersampling (casuale, NearMiss, legami di Tomek, centroidi dei cluster)
- Raccogliere più dati
- Usare il parametro
class_weightdei modelli di classificazione, così che il modello impari allo stesso modo dalle classi minoritarie e da quelle maggioritarie - Guardare le prestazioni di altri modelli invece di affidarsi a uno solo
- Cambiare approccio, per esempio con il rilevamento di anomalie o di cambiamenti
Per prima cosa esaminiamo il dataset Credit Card Fraud Detection, che è sbilanciato, e poi applichiamo diversi metodi per gestire questo squilibrio.
Esame del dataset
Individuare le frodi è importante per le società di carte di credito: non vogliono che ai clienti vengano addebitati acquisti che non hanno effettuato.
Dataset: creditcard.csv (Kaggle)
Con questo dataset vogliamo costruire un modello che riconosca le transazioni fraudolente. I dati provengono da transazioni con carta effettuate in Europa a settembre 2013; ogni transazione è etichettata con 1 se è una frode e con 0 se non lo è. Per motivi di riservatezza le informazioni di contesto sono poche, e tutte le variabili tranne Time e Amount sono state trasformate con la PCA (analisi delle componenti principali).
Time: secondi trascorsi tra la prima transazione e ciascuna transazioneAmount: importo della transazione
Prima leggiamo i dati, controlliamo i valori mancanti e guardiamo la distribuzione della variabile Class. Poi standardizziamo Amount e Time, dividiamo i dati con il metodo hold-out e costruiamo un modello di classificazione con la regressione logistica. Lavoreremo con un solo modello.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()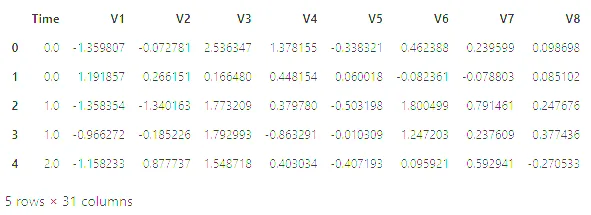
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Il codice stampa le etichette in turco: numero di osservazioni e numero di variabili.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()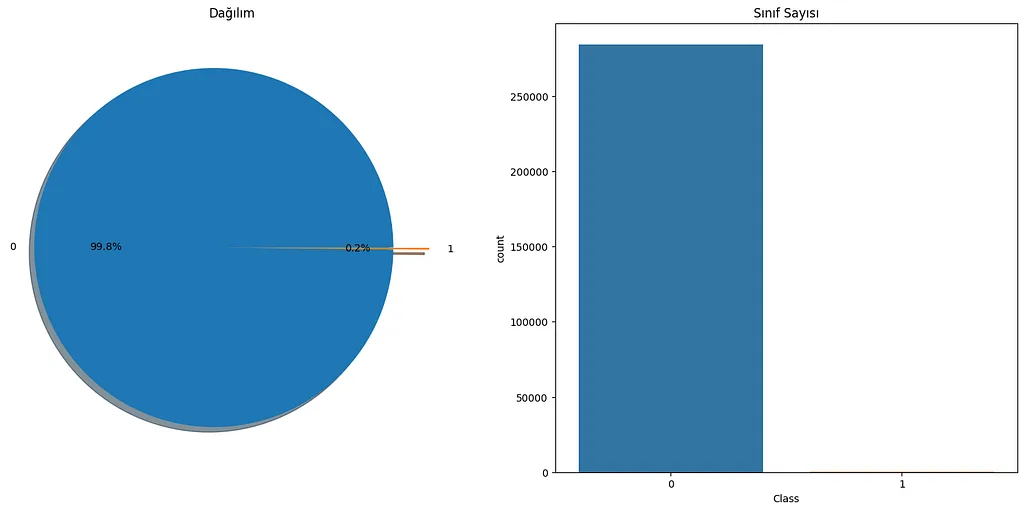
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()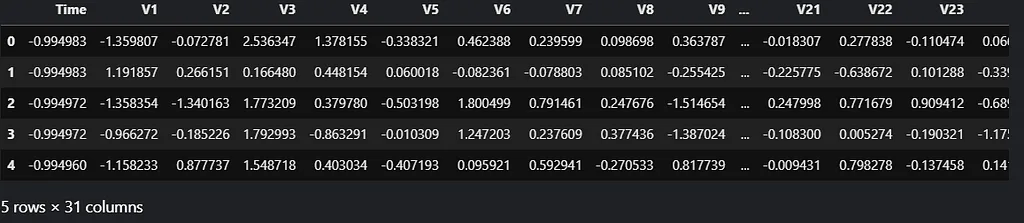
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999L’accuratezza è la quota di previsioni corrette sul totale delle previsioni. Il nostro modello ottiene 0,999. Potremmo dire che funziona alla perfezione, no? Guardiamo anche la matrice di confusione.
La matrice di confusione
La matrice di confusione è una tabella che riassume come si comporta un modello di classificazione sui dati di test. Contiene le quattro combinazioni di valori previsti e reali. Qui consideriamo la frode come classe positiva:
- Vero positivo (TP): previsto positivo, e la previsione è corretta.
- Vero negativo (TN): previsto negativo, e la previsione è corretta.
- Falso positivo (FP): previsto positivo, ma la previsione è sbagliata.
- Falso negativo (FN): previsto negativo, ma la previsione è sbagliata.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')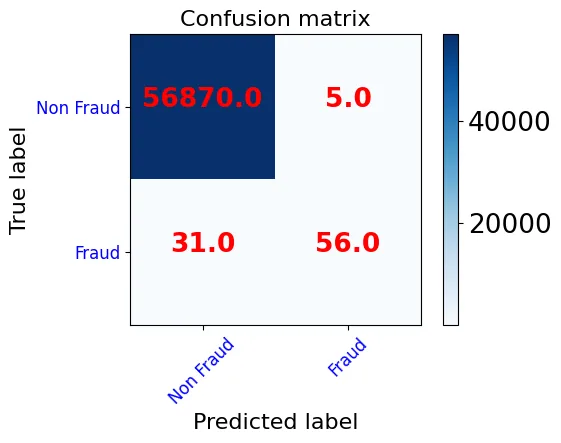
- Delle 56875 transazioni realmente normali, 56870 sono previste correttamente e 5 sono segnalate per errore come frode (FP).
- Delle 87 frodi reali, 56 vengono individuate (TP) e 31 sfuggono (FN).
Il modello dichiara 0,999 di accuratezza, ma la matrice di confusione mostra un alto tasso di errore nella classe frode. Il modello prevede bene la classe maggioritaria e male quella minoritaria. Poiché le transazioni normali sono molte più di quelle fraudolente, il modello sembra efficace semplicemente perché prevede la classe normale.
La lezione: l’accuratezza non è una buona misura delle prestazioni dei modelli di classificazione, soprattutto con dati sbilanciati come i nostri. Vediamo come affrontare lo squilibrio, quali metodi applicare e con quali metriche misurare le prestazioni.
Scegliere le metriche giuste
Abbiamo visto che l’accuratezza non basta; servono altre metriche per misurare le prestazioni.
Precisione (precision): la quota di esempi previsti come positivi che sono davvero positivi. Una precisione bassa significa molti falsi positivi. Precisione = TP / (TP + FP).
Richiamo (recall): la quota dei positivi reali che abbiamo previsto come positivi. Un richiamo basso significa molti falsi negativi; deve essere il più alto possibile. Richiamo = TP / (TP + FN).
Punteggio F1: è difficile confrontare un modello con precisione bassa e richiamo alto con uno che presenta la situazione opposta. Il punteggio F1 li misura insieme come media armonica di precisione e richiamo. F1 = 2 × (Precisione × Richiamo) / (Precisione + Richiamo).
Guardiamo queste metriche per il nostro modello. Il report di classificazione mostra le metriche principali per classe.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))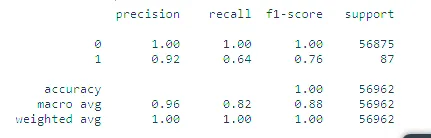
Precisione per classe:
- Classe 0 (normale): 56870 + 31 = 56901 transazioni previste come normali, di cui 56870 correttamente. Precisione ≈ 1,00 (56870 / 56901).
- Classe 1 (frode): 5 + 56 = 61 transazioni previste come frode, di cui 56 correttamente. Precisione ≈ 0,92 (56 / 61).
Richiamo per classe:
- Classe 0 (normale): delle 56870 + 5 = 56875 transazioni normali, 56870 sono previste correttamente. Richiamo ≈ 1,00.
- Classe 1 (frode): delle 31 + 56 = 87 transazioni fraudolente, 56 sono previste correttamente. Richiamo = 56 / 87 ≈ 0,64.
I valori di richiamo mostrano chiaramente il fallimento sulla classe 1. Il punteggio F1 è la media armonica di richiamo e precisione. Il valore support è il numero effettivo di esempi in ciascuna classe; la differenza tra le classi rivela una debolezza strutturale delle misure, perché lo squilibrio stesso le influenza.
La curva ROC
La curva ROC è un grafico che mostra le prestazioni di un modello di classificazione su tutte le soglie di decisione. Traccia due valori:
- Tasso di veri positivi (TPR), cioè il richiamo: TPR = TP / (TP + FN)
- Tasso di falsi positivi (FPR), cioè la frequenza dei falsi allarmi sulle transazioni normali: FPR = FP / (FP + TN)
La curva traccia il TPR rispetto al FPR a soglie diverse; parte da (0,0) e finisce in (1,1). Un buon modello produce una curva che sale rapidamente da 0 a 1.
AUC (area sotto la curva ROC)
L’AUC riassume la curva ROC in un solo numero: misura tutta l’area sotto la curva da (0,0) a (1,1). Il valore migliore è 1; una previsione casuale dà 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)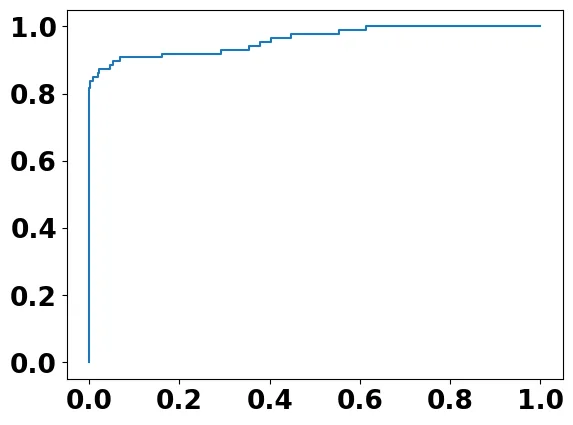
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Nota: l’AUC valuta le prestazioni complessive di classificazione. Poiché non dà più peso a una classe che all’altra, non riflette bene le prestazioni sulla classe minoritaria.
Ora applichiamo al dataset diversi metodi per eliminare lo squilibrio.
Importante: questi metodi vanno applicati solo al set di addestramento. Se applicati al set di test, rendono impossibile una valutazione corretta.
Il ricampionamento
Il ricampionamento (resampling) rende un dataset più equilibrato aggiungendo nuovi esempi alla classe minoritaria o togliendo esempi dalla classe maggioritaria. L’undersampling elimina esempi della maggioranza; l’oversampling moltiplica gli esempi della minoranza.
Oversampling
L’oversampling equilibra i dati duplicando gli esempi della classe minoritaria.
Oversampling casuale:
- Si aggiungono esempi della minoranza scelti a caso per equilibrare il dataset.
- Si può usare quando il dataset è piccolo.
- Può causare overfitting.
RandomOverSampler accetta l’argomento sampling_strategy. Con sampling_strategy='minority' la classe minoritaria viene moltiplicata fino a eguagliare la classe maggioritaria. L’argomento accetta anche un numero decimale: se la classe maggioritaria ha 1000 esempi e la minoritaria 100, sampling_strategy=0.5 porta la minoranza a 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')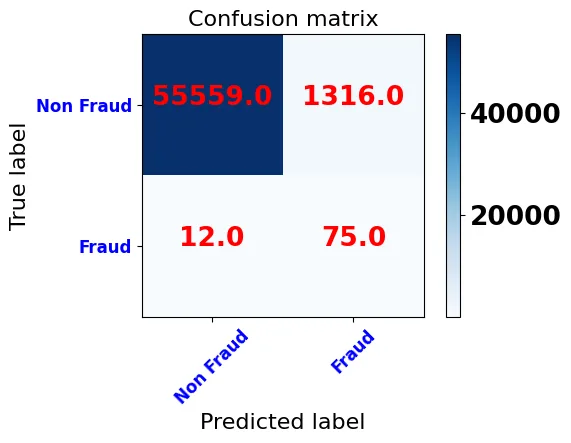
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Dopo l’oversampling casuale l’accuratezza del modello scende a 0,977. La matrice di confusione e il report mostrano che la maggior parte delle transazioni segnalate come frode sono falsi allarmi, e questo abbassa la precisione della classe 1 a 0,05. In cambio, il richiamo della classe 1 sale a 0,86: vengono individuate 75 frodi su 87. Le transazioni normali sono previste un po’ peggio che con il primo modello, ma questo balzo nell’individuare le frodi è un valido motivo per preferire il modello addestrato dopo l’oversampling casuale.
Oversampling SMOTE:
Per evitare l’overfitting si generano esempi sintetici della minoranza invece di copie:
- Si sceglie a caso un esempio della classe minoritaria.
- Si trovano i suoi k vicini più prossimi.
- Si sceglie a caso un vicino; nello spazio delle feature si traccia un segmento tra l’esempio e quel vicino, e l’esempio sintetico viene creato su quel segmento.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975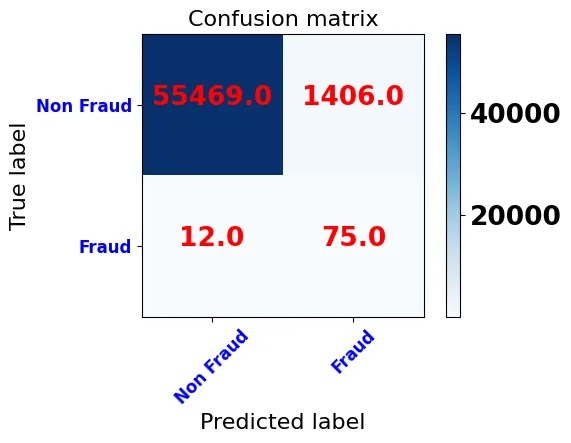
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962I risultati dopo SMOTE sono simili a quelli dell’oversampling casuale: di nuovo vengono individuate 75 frodi su 87, mentre i falsi allarmi salgono a 1406.
Undersampling
L’undersampling equilibra i dati togliendo esempi della classe maggioritaria ed è adatto ai dataset grandi. Il nostro dataset non è abbastanza grande perché funzioni bene, ma spieghiamo i metodi e mostriamo come applicarne alcuni.
Undersampling casuale:
- Gli esempi da togliere sono scelti a caso.
- Si può usare se si dispone di un dataset grande.
- La scelta casuale può far perdere informazioni.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64Undersampling NearMiss:
- Riduce la perdita di informazioni.
- Si basa sull’algoritmo KNN.
- Calcola la distanza degli esempi della maggioranza da quelli della minoranza.
- Mantiene gli esempi della maggioranza più vicini alla classe minoritaria, in base a un dato valore di k.
Legami di Tomek: per ogni coppia di esempi più vicini appartenenti a classi diverse si toglie l’esempio della maggioranza, aumentando la separazione tra le due classi.
Centroidi dei cluster: gli esempi poco importanti vengono tolti dal dataset; l’importanza di un esempio si stabilisce con il clustering.
Undersampling e oversampling si possono combinare per ottenere dataset più equilibrati.
Altri metodi
- Raccogliere più dati
- Usare il parametro
class_weight, così che il modello impari allo stesso modo dalle classi minoritarie e da quelle maggioritarie - Guardare le prestazioni di altri modelli, non di uno solo
- Cambiare approccio, per esempio con il rilevamento di anomalie o di cambiamenti
Quale metodo funzioni meglio dipende dal dataset in esame. Provare i diversi metodi e scegliere quello adatto ai tuoi dati dà il risultato migliore.
Fonti
- Kaggle: sui dataset sbilanciati (Yasin Tanış, in turco)
- Miuul: che cos’è un dataset sbilanciato (in turco)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes