

Dengesiz Veri Seti Nedir? Nasıl Başa Çıkılır?
Yazan Yasin TANIŞ
Dengesiz veri seti nedir
Bir iş için sınıflandırma modeli kuruyorsunuz ve modelin doğruluğu %95 çıkıyor. Her şey yolunda görünüyor. Model kullanılmaya başlıyor, ama kısa süre sonra hep aynı sınıfı tahmin ettiği fark ediliyor. Veri setine yeniden baktığınızda, tespit edilemeyen sınıfın verideki payının yalnızca %5 olduğunu görüyorsunuz. Yani modelin başarısızlığı dengesiz veri setinden (imbalanced dataset) kaynaklanıyor.
Dengesiz veri seti sınıflandırma problemlerinde, sınıfların dağılımı birbirine yakın olmadığında ortaya çıkar. Sorun, çoğunluk sınıfının azınlık sınıfını bastırmasıdır: model çoğunluk sınıfına yakınlaşır ve azınlık sınıfını kötü sınıflandırır.
Dengesiz veriyle karşılaştığımızda doğru gözlem yapmak ve dengeyi sağlamak için başvurabileceğimiz yöntemler şunlar:
- Doğru metrikleri seçmek: precision, recall, F1 skoru, ROC eğrisi ve AUC
- Yeniden örnekleme: oversampling (rastgele ve SMOTE) ve undersampling (rastgele, NearMiss, Tomek bağları, küme merkezleri)
- Daha fazla veri toplamak
- Sınıflandırma modellerindeki
class_weightparametresiyle azınlık ve çoğunluk sınıflarından eşit öğrenen bir model kurmak - Tek bir modele bağlı kalmayıp başka modellerin performansına da bakmak
- Farklı bir yaklaşımla anomali ya da değişim tespiti yapmak
Önce dengesizlik içeren Credit Card Fraud Detection veri setini inceleyeceğiz, sonra bu dengesizlikle başa çıkmak için çeşitli yöntemler uygulayacağız.
Veri setinin incelenmesi
Kredi kartı şirketleri için dolandırıcılığı tespit etmek önemlidir; müşterilerinin yapmadıkları alışverişler için ücretlendirilmesini istemezler.
Veri seti: creditcard.csv (Kaggle)
Bu veri setiyle dolandırıcılık işlemlerini tespit eden bir model kurmak istiyoruz. Veri, Eylül 2013'te Avrupa'da kredi kartıyla yapılan işlemlerden oluşuyor; her işlem dolandırıcılıksa 1, değilse 0 olarak etiketlenmiş. Gizlilik nedeniyle arka plan bilgisi az; Time ve Amount dışındaki değişkenler PCA (temel bileşen analizi) ile dönüştürülmüş.
Time: ilk işlemle her işlem arasında geçen saniyeAmount: işlem tutarı
Önce veri setini okuyup boş değer olup olmadığına ve Class değişkeninin dağılımına bakıyoruz. Ardından Amount ve Time değişkenlerini standartlaştırıyor, veriyi hold-out yöntemiyle ayırıyor ve lojistik regresyonla bir sınıflandırma modeli kuruyoruz. Tek bir model üzerinden ilerleyeceğiz.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()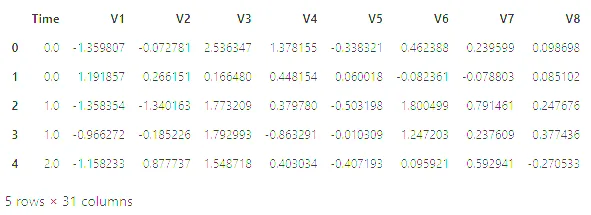
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()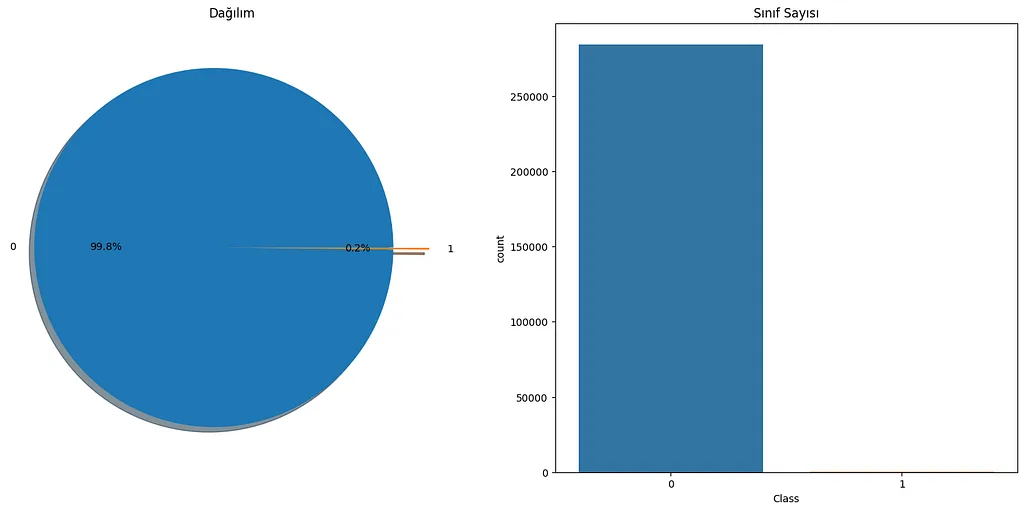
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()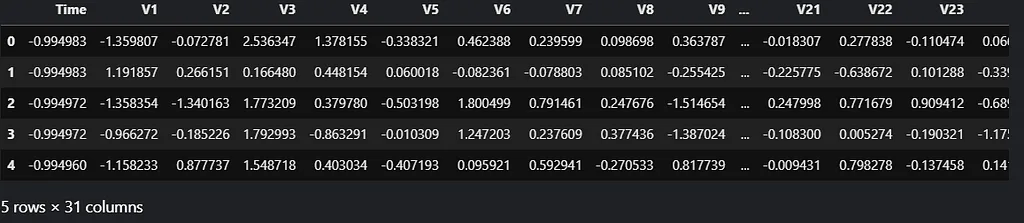
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Doğruluk (accuracy), doğru tahminlerin tüm tahminlere oranıdır. Modelimizin doğruluk skoru 0,999. Model mükemmel çalışıyor diyebiliriz, değil mi? Performansını görmek için karışıklık matrisine de bakalım.
Karışıklık matrisi
Karışıklık matrisi (confusion matrix), bir sınıflandırma modelinin test verisindeki performansını özetleyen bir tablodur. Tahmin edilen ve gerçek değerlerin dört kombinasyonunu içerir. Burada dolandırıcılığı (fraud) pozitif sınıf kabul ediyoruz:
- Doğru pozitif (TP): pozitif tahmin edildi ve doğru.
- Doğru negatif (TN): negatif tahmin edildi ve doğru.
- Yanlış pozitif (FP): pozitif tahmin edildi ama yanlış.
- Yanlış negatif (FN): negatif tahmin edildi ama yanlış.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')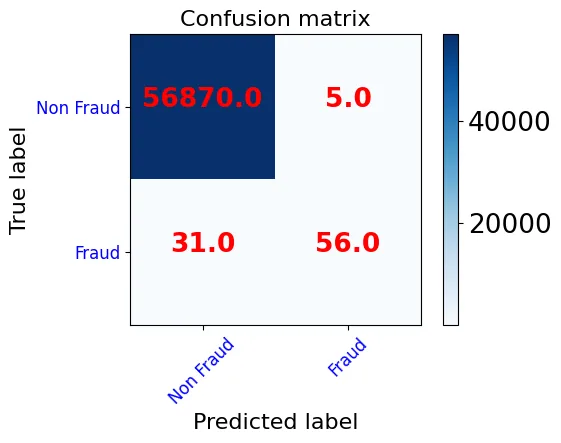
- Gerçekte normal olan 56875 işlemin 56870'i doğru tahmin edilmiş, 5'i yanlışlıkla dolandırıcılık sanılmış (FP).
- Gerçekte dolandırıcılık olan 87 işlemin 56'sı yakalanmış (TP), 31'i kaçırılmış (FN).
Model bize 0,999 doğrulukla çalıştığını söylüyor, ama karışıklık matrisine bakınca dolandırıcılık sınıfındaki hataların oranı oldukça yüksek. Model çoğunluk sınıfını tahmin etmekte başarılı, azınlık sınıfında ise değil. Normal işlemlerin sayısının dolandırıcılık işlemlerinden çok daha fazla olması, modelin normal sınıfı tahmin etmede başarılı görünmesine yol açıyor.
Bu gözlemden şunu çıkarabiliriz: doğruluk, sınıflandırma modelleri için iyi bir performans ölçüsü değildir; özellikle de veri bizimki gibi dengesizse. Şimdi dengesizlikle nasıl başa çıkabileceğimize, hangi yöntemleri uygulayabileceğimize ve performansı hangi metriklerle ölçeceğimize bakalım.
Doğru metrikleri seçmek
Doğruluğun yeterli olmadığını gördük; performansı ölçmek için başka metriklere bakmamız gerekiyor.
Precision (kesinlik): pozitif tahmin edilenlerin ne kadarının gerçekten pozitif olduğunu gösterir. Precision düşükse çok sayıda yanlış pozitif vardır. Precision = TP / (TP + FP).
Recall (duyarlılık): gerçekte pozitif olanların ne kadarını pozitif tahmin ettiğimizi gösterir. Recall düşükse çok sayıda yanlış negatif vardır; olabildiğince yüksek olmalıdır. Recall = TP / (TP + FN).
F1 skoru: precision'ı düşük ama recall'u yüksek bir modelle tam tersi bir modeli karşılaştırmak zordur. F1 skoru ikisini birlikte ölçer; precision ve recall'un harmonik ortalamasıdır. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Bu metrikleri modelimiz için inceleyelim. Sınıflandırma raporu, temel sınıflandırma ölçütlerini sınıf bazında gösterir.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))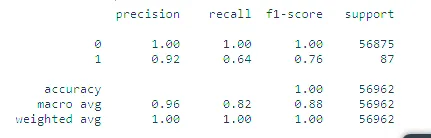
Precision'ı her sınıf için inceleyelim:
- 0 (normal) sınıfı: 56870 + 31 = 56901 işlem normal tahmin edilmiş, bunların 56870'i doğru. Precision ≈ 1,00 (56870 / 56901).
- 1 (dolandırıcılık) sınıfı: 5 + 56 = 61 işlem dolandırıcılık tahmin edilmiş, bunların 56'sı doğru. Precision ≈ 0,92 (56 / 61).
Recall'u her sınıf için inceleyelim:
- 0 (normal) sınıfı: 56870 + 5 = 56875 normal işlemin 56870'i doğru tahmin edilmiş. Recall ≈ 1,00.
- 1 (dolandırıcılık) sınıfı: 31 + 56 = 87 dolandırıcılık işleminin 56'sı doğru tahmin edilmiş. Recall = 56 / 87 ≈ 0,64.
Recall değerlerine bakınca 1 sınıfını tahmin etmedeki başarısızlık açıkça görülüyor. F1 skoru recall ve precision'ın harmonik ortalamasıdır. Support ise her sınıfın gerçek örnek sayısıdır; sınıflar arasındaki bu sayı farkının ölçümleri etkilediğini, yani ölçümlerin yapısal bir zayıflığını gösterir.
ROC eğrisi
ROC eğrisi, bir sınıflandırma modelinin tüm karar eşiklerindeki performansını gösteren bir grafiktir. İki değeri çizer:
- Doğru pozitif oranı (TPR), yani recall: TPR = TP / (TP + FN)
- Yanlış pozitif oranı (FPR), yani normal işlemlere yanlış alarm verme oranı: FPR = FP / (FP + TN)
Eğri, farklı eşiklerde TPR'yi FPR'ye karşı çizer; (0,0)'da başlar ve (1,1)'de biter. İyi bir model 0'dan 1'e hızla yükselen bir eğri üretir.
AUC (ROC eğrisinin altındaki alan)
AUC, ROC eğrisini tek bir sayıyla özetler: (0,0)'dan (1,1)'e kadar eğrinin altındaki alanın tamamını ölçer. En iyi değer 1, rastgele tahminin değeri 0,5'tir.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)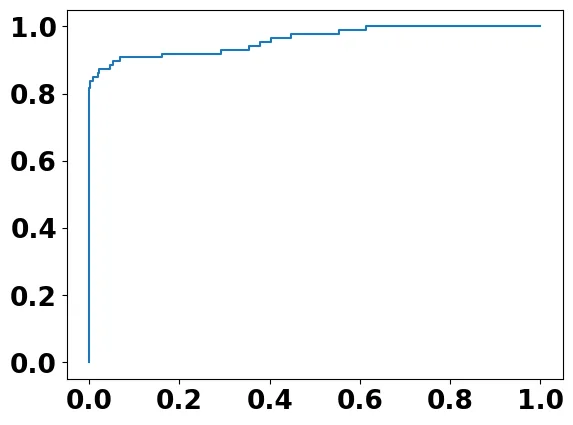
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Not: AUC genel sınıflandırma performansını değerlendirir. Bir sınıfa diğerinden fazla önem vermediği için azınlık sınıfındaki performansı iyi yansıtmaz.
Şimdi dengesizliği gidermek için veri setine çeşitli yöntemler uygulayalım.
Önemli: bu yöntemler yalnızca eğitim setine uygulanmalıdır. Test setine uygulanırsa doğru bir değerlendirme yapılamaz.
Yeniden örnekleme
Yeniden örnekleme (resampling), azınlık sınıfına yeni örnekler ekleyerek ya da çoğunluk sınıfından örnekler çıkararak veri setini daha dengeli hâle getirmektir. Undersampling çoğunluk sınıfından örnek atar; oversampling azınlık sınıfının örneklerini çoğaltır.
Oversampling
Oversampling, azınlık sınıfının örneklerini çoğaltarak veri setini dengeler.
Rastgele oversampling:
- Azınlık sınıfından rastgele seçilen örnekler eklenerek veri seti dengelenir.
- Veri seti küçükse kullanılabilir.
- Aşırı öğrenmeye (overfitting) yol açabilir.
RandomOverSampler bir sampling_strategy argümanı alır. sampling_strategy='minority' dendiğinde azınlık sınıfı, çoğunluk sınıfının sayısına eşitlenene kadar çoğaltılır. Bu argümana ondalıklı bir değer de verilebilir: örneğin çoğunluk sınıfında 1000, azınlık sınıfında 100 örnek varsa sampling_strategy=0.5 azınlık sınıfını 500 örneğe çıkarır.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')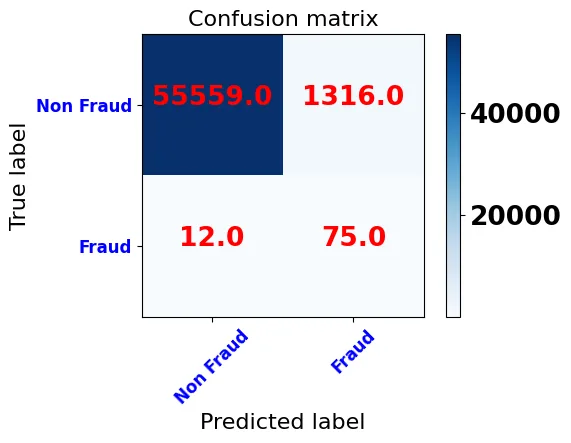
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Rastgele oversampling sonrası eğitilen modelin doğruluğu 0,977'ye düşüyor. Karışıklık matrisine ve sınıflandırma raporuna bakınca, dolandırıcılık olarak işaretlenen işlemlerin çoğunun yanlış alarm olduğu görülüyor; bu da 1 sınıfının precision'ını 0,05'e düşürüyor. Buna karşılık 1 sınıfının recall'u 0,86'ya çıkıyor: 87 dolandırıcılık işleminin 75'i yakalanıyor. Normal sınıfın tahmin başarısı ilk modele göre biraz düşse de, dolandırıcılığı yakalama oranındaki bu artış, rastgele oversampling sonrası kurulan modeli tercih etmek için güçlü bir neden.
SMOTE oversampling:
Aşırı öğrenmeyi önlemek için azınlık sınıfından kopya yerine sentetik örnekler üretilir:
- Önce azınlık sınıfından rastgele bir örnek seçilir.
- Bu örneğin en yakın k komşusu bulunur.
- Komşulardan biri rastgele seçilir; seçilen örnekle bu komşu arasında özellik uzayında bir doğru parçası çizilir ve sentetik örnek bu doğru üzerinde oluşturulur.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975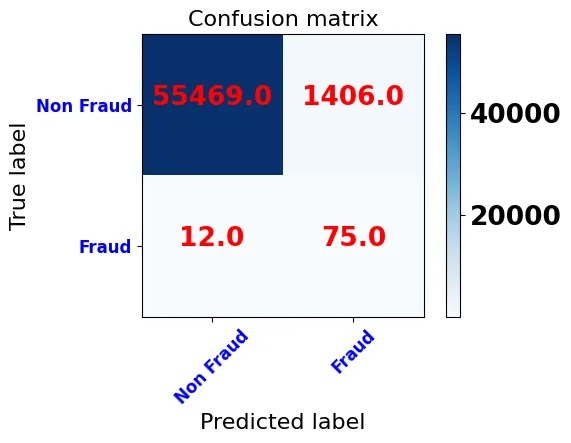
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962SMOTE sonrası sonuçlar rastgele oversampling'e benziyor: 87 dolandırıcılık işleminin yine 75'i yakalanıyor, yanlış alarm sayısı ise 1406'ya çıkıyor.
Undersampling
Undersampling, çoğunluk sınıfından örnekler çıkararak veri setini dengeler ve büyük veri setlerinde kullanılabilir. Elimizdeki veri seti yeterince büyük olmadığı için verimli sonuç vermeyecek, ama yöntemleri açıklayıp bazılarının nasıl uygulandığını göstereceğiz.
Rastgele undersampling:
- Çıkarılacak örnekler rastgele seçilir.
- Büyük bir veri setiniz varsa kullanılabilir.
- Rastgele seçim nedeniyle bilgi kaybı yaşanabilir.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss undersampling:
- Bilgi kaybını azaltır.
- KNN algoritmasına dayanır.
- Çoğunluk sınıfındaki örneklerin azınlık sınıfındaki örneklere uzaklığı hesaplanır.
- Belirtilen k değerine göre azınlık sınıfına en yakın örnekler korunur.
Tomek bağları: farklı sınıflara ait birbirine en yakın iki örnekten çoğunluk sınıfına ait olan kaldırılır; böylece iki sınıf arasındaki boşluk artar.
Küme merkezleri (cluster centroids): önemsiz örnekler veri setinden çıkarılır; bir örneğin önemli olup olmadığı kümeleme ile belirlenir.
Undersampling ve oversampling birlikte kullanılarak daha dengeli veri setleri oluşturulabilir.
Diğer yöntemler
- Daha fazla veri toplamak
class_weightparametresiyle azınlık ve çoğunluk sınıflarından eşit öğrenen bir model kurmak- Tek bir modele değil, başka modellerin performansına da bakmak
- Farklı bir yaklaşımla anomali ya da değişim tespiti yapmak
Hangi yöntemin en iyi sonucu vereceği eldeki veri setine bağlıdır. Yöntemleri deneyip veri setine en uygun olanı seçmek en iyi sonucu verir.
Kaynaklar
- Kaggle: Dengesiz veri seti üzerine (Yasin Tanış)
- Miuul: Dengesiz veri seti nedir, nasıl başa çıkılır
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes